Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr


Automatische vertaling
Ik evalueer, benchmark en optimaliseer je AI prompts of LLM-workflows om betrouwbaarheid, consistentie en outputkwaliteit te verbeteren.
Ik beoordeel je bestaande prompt, test deze met voorbeeldinputs, identificeer zwakke punten of faalpatronen en bied geoptimaliseerde promptverbeteringen op basis van gestructureerde evaluatie en benchmarking.
Afhankelijk van het gekozen pakket kunnen de diensten onder meer omvatten:
Mijn proces maakt gebruik van een eigen evaluatiekader dat is ontworpen om verbeteringen te meten met bewijsgebaseerde resultaten in plaats van trial-and-error promptbewerking.
Deze service is geschikt voor:
Het doel is om je AI-systemen betrouwbaarder te laten presteren bij echte inputs en randgevallen.
Let op, testcases zijn beperkt tot 5 voor Basic, 20 voor standaard en 50 voor premium.
Data Driven AI Evaluation and Optimization
Talen
Automatische vertaling
Automatische vertaling
Welke problemen kun je helpen verbeteren?
Voorbeelden zijn: Inconsistente antwoorden Hallucinaties Slechte instructievolging Zwakke redenering Tonen/stijlproblemen Ongeldige JSON-opmaak Overmatige verbosity Betrouwbaarheidsproblemen bij verschillende inputs
Levert u rapportages aan?
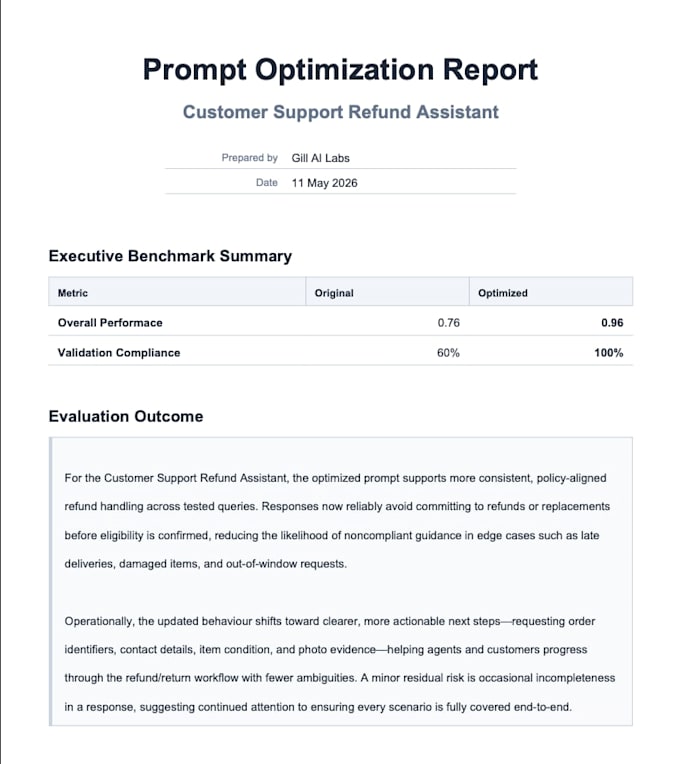
Ja. Afhankelijk van het gekozen pakket kunnen rapporten onder meer bevatten: Benchmarkbevindingen Vergelijkingen voor en na Optimalisatie-aanbevelingen Evaluatiesamenvattingen Betrouwbaarheidsanalyse
Kun je prompts testen met datasets of meerdere scenario's?
Ja. Hogere pakketten kunnen gestructureerde benchmarktesten omvatten over meerdere testgevallen en randgevallen.
Beloof je perfecte AI-uitvoer?
Geen enkel AI-systeem kan worden gegarandeerd dat het in alle situaties perfect presteert. Het doel is om betrouwbaarheid, consistentie en de algehele outputkwaliteit aanzienlijk te verbeteren met gestructureerde evaluatie- en optimalisatiemethoden.
Welke AI-modellen ondersteunt u?
Ik werk met prompts en workflows voor: OpenAI ChatGPT Anthropic Claude Google Gemini
Wat heb je van me nodig?
Gelieve te verstrekken: Je huidige prompt of workflow Het doel van het AI-systeem Voorbeeldinputs en outputs (indien beschikbaar) Eventuele opmaak-, toon- of zakelijke vereisten Details van eventuele problemen die je ondervindt