Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Ben je op zoek naar een betrouwbare en snelle geautomatiseerde pipeline om FASTA biologische sequenties te verwerken zonder handmatig werk?
Ik ben gespecialiseerd in het bouwen van modulaire, reproduceerbare Bash- en Python-pipelines op maat voor NCBI FASTA sequentie-extractie en downstream bioinformatica analyse.
### Wat ik aanbied in deze dienst:
- Geautomatiseerde NCBI Sequentie Ophaling: Batch download van FASTA sequenties met behulp van Accession IDs.
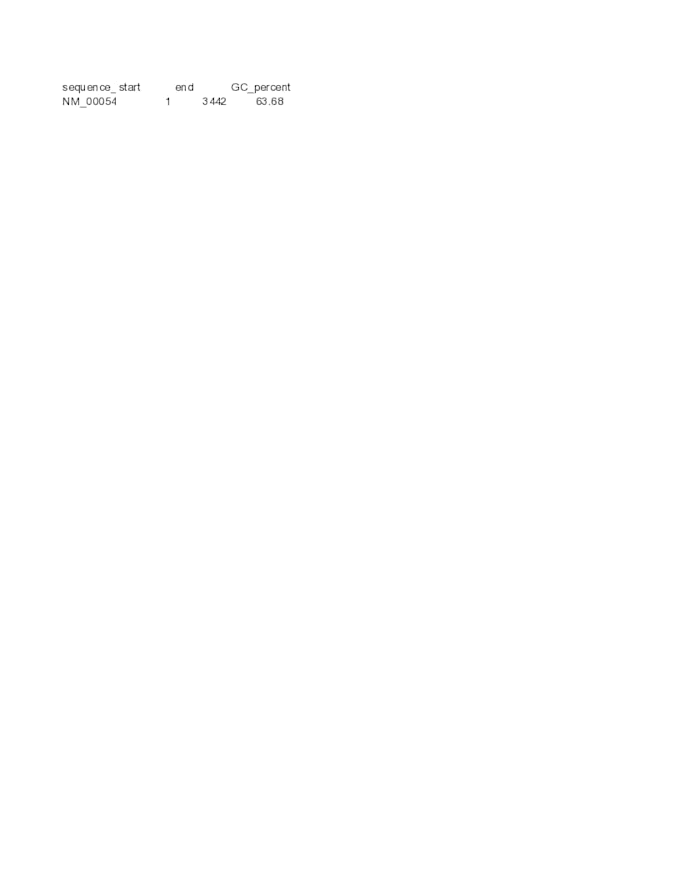
- Sequentie Statistieken & Metrics: Bereken de totale lengte, GC/AT inhoud percentages en N50 statistieken.
- Venster-gebaseerde GC Profilering: Gedetailleerde GC-inhoud analyse over schuivende vensters.
- Sequentie Manipulatie: Geautomatiseerde reverse complement generatie en opschoning van FASTA headers.
- Gestructureerde Data Export: Schoon TSV/CSV rapport voor downstream analyse.
### Waarom kiezen voor mijn service?
- Schone, goed gedocumenteerde code: Modulaire Bash- en Python-scripts ontworpen voor naadloze hergebruikbaarheid.
- Opslaggeoptimaliseerde workflows: Efficiënte command-line uitvoering op Linux-omgevingen.
- Snelle doorlooptijd & volledige ondersteuning: Gedetailleerde gebruikersinstructies inbegrepen voor soepele uitvoering op jouw terminal.
Voel je vrij om me een bericht te sturen met jouw specifieke projectvereisten voordat je een bestelling plaatst!