Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Heb je een machine-learning model nodig dat je data omzet in bruikbare voorspellingen?
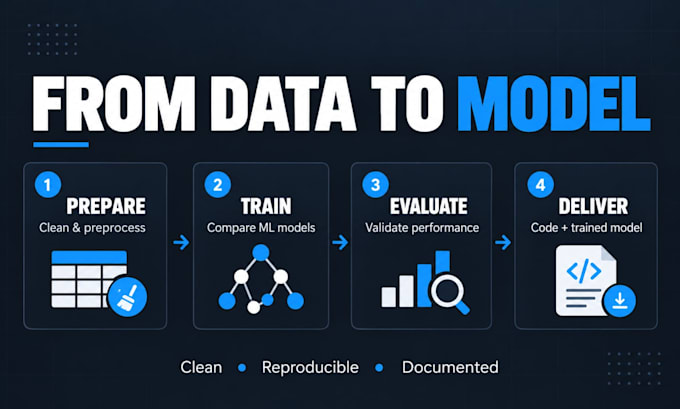
Ik bouw een op maat gemaakt classificatie- of regressiemodel met jouw gestructureerde/tabulaire dataset en lever duidelijke evaluaties, reproduceerbare Python-code en gedocumenteerde resultaten.
Ik kan helpen met:
Neem contact met me op voordat je bestelt als je dataset uitgebreide schoonmaak, meerdere databronnen, deep learning, NLP, tijdreeksvoorspelling, cloud deployment of grootschalige verwerking vereist.
Resultaten hangen af van je dataset en evaluatie-instellingen, dus specifieke nauwkeurigheid of zakelijke uitkomsten kunnen niet worden gegarandeerd.


Programmeertaal:
Python
•
R
•
MATLAB
•
SQL
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
•
Overige
Tools:
Jupyter-notitieboek
•
opencv
•
OpenNN
•
tensorflow
•
Excel
•
Colab
Automatische vertaling
Aan welke soorten machine-learning problemen werk je?
Deze dienst richt zich op supervised machine-learning problemen met gestructureerde/tabulaire data, vooral classificatie en regressie. Neem eerst contact op voor tijdreeksvoorspellingen, NLP, computer vision, deep learning of ongewone datatypes.
Wat is classificatie?
Classificatie voorspelt een categorie of klasse, zoals churn/niet churn, fraude/niet fraude, goedgekeurd/afgewezen, of een van meerdere mogelijke klassen.
Wat is regressie?
Regressie voorspelt een numerieke waarde, zoals een prijs, vraagniveau, score, omzetbedrag of een andere continue target.
Welke data moet ik aanleveren?
Lever een gestructureerde dataset aan, zoals CSV, Excel of een ander overeengekomen tabular formaat, samen met een beschrijving van de kolommen en de target die je wilt voorspellen.
Kun je mijn dataset opschonen?
Schoonmaak is inbegrepen binnen de pakketlimieten. Uitgebreide schoonmaak, het samenvoegen van meerdere databronnen, handmatige labeling of het herbouwen van sterk incomplete datasets kan een aangepaste offerte vereisen.
Welke machine-learning algoritmes gebruik je?
Het algoritme hangt af van je dataset en voorspellingstaak. Geschikte benaderingen kunnen regressiemodellen, beslisbomen, Random Forest, gradient boosting, XGBoost en andere geschikte klassieke machine-learning methoden omvatten.
Kun je een specifieke nauwkeurigheid garanderen?
Nee. Modelprestaties hangen sterk af van de kwaliteit, kwantiteit, relevantie, balans en voorspelbaarheid van de aangeleverde data. Ik gebruik passende evaluatiemethoden en rapporteer duidelijk de behaalde resultaten.
Ontvang ik de broncode?
Ja. Je ontvangt de reproduceerbare Python-code of notebook die in je pakket is inbegrepen, samen met relevante modelartefacten en documentatie.
Kun je het model deployen?
Het Premium pakket bevat inference API prototype of batch prediction script. Volledige cloud deployment, monitoring, schaalbare infrastructuur en doorlopende MLOps zijn aparte diensten.