Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD


Automatische vertaling
Gig Beschrijving
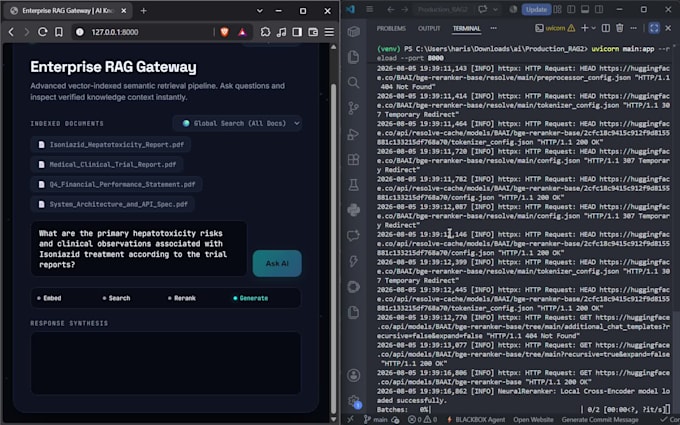
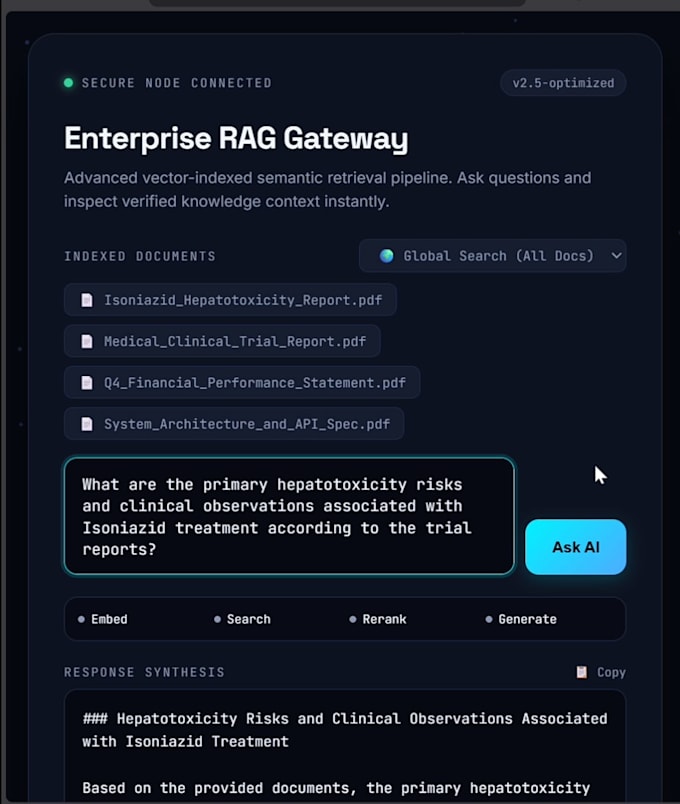
Wil je een AI die nauwkeurig kan chatten met je PDFs, documenten of database? Ik bouw een productieklare RAG-systeem voor jouw bedrijf...
Ik ben gespecialiseerd in productie GenAI-architecturen en asynchrone backend-systemen met Python, FastAPI, Vector DBs en LLMs (OpenAI, Groq, Llama 3).
️ Belangrijkste mogelijkheden:
Technische stack:
Python | FastAPI | Qdrant | Pinecone | LlamaIndex | LangChain | OpenAI | Groq | Docker
Waarom voor mij kiezen?
Laten we je project bespreken! Stuur me een bericht voordat je een bestelling plaatst, zodat we de architectuur kunnen afstemmen op jouw specifieke data-behoeften.
Enterprise Rag and AI Systems Engineer
Talen
Automatische vertaling
Automatische vertaling
Q1: Welke prerequisites moet ik aanleveren voordat ik begin?
Antwoord: Je moet je project specificaties, voorbeeldgegevens/documenten en API-sleutels voor de gekozen LLM- of Vector DB-aanbieders (bijv. OpenAI, Groq, Pinecone) delen. Als je geen sleutels klaar hebt, kan ik je begeleiden bij het veilig instellen ervan in een .env-bestand.
Q2: Blijven mijn data en API-sleutels veilig tijdens de ontwikkeling?
Antwoord: Ja, absoluut. Je data, bedrijfslogica en inloggegevens blijven 100% vertrouwelijk. Alle gevoelige gegevens worden geladen via environment variables (.env) en worden nooit hardcoded of gedeeld.
Q3: Kan je aangepaste document parsing doen zoals complexe tabellen en PDFs?
Antwoord: Ja. Ik gebruik layout-aware parsing tools (zoals LlamaParse) en aangepaste chunking strategieën om tabellen, PDFs, Markdown en tekstbestanden netjes te extraheren en structureren voordat ik ze indexeer in de vector database.
Q4: Is de applicatie klaar voor cloud deployment?
Antwoord: Ja. Elke oplevering bevat gestructureerde Python-code, FastAPI endpoints, een .env.example sjabloon en een geoptimaliseerd Dockerfile zodat je direct kunt deployen naar AWS, GCP, Azure of een lokale server.
Q5: Wat gebeurt er als een LLM-provider uitvalt of rate limits bereikt?
Antwoord: Ik bouw ingebouwde veerkracht met retry-algoritmes en multi-provider failover routing (bijvoorbeeld automatisch overschakelen van Groq naar OpenAI als rate limits worden bereikt) om hoge uptime te garanderen.