Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD


Automatische vertaling
Ben je op zoek naar een manier om aangepaste data te integreren in Large Language Models (LLMs) met hoge precisie en lage latency?
Ik ontwikkel robuuste, productieklare Retrieval-Augmented Generation (RAG) systemen en Agentic AI-workflows op maat voor jouw bedrijfsbehoeften.
Wat ik aanbied:
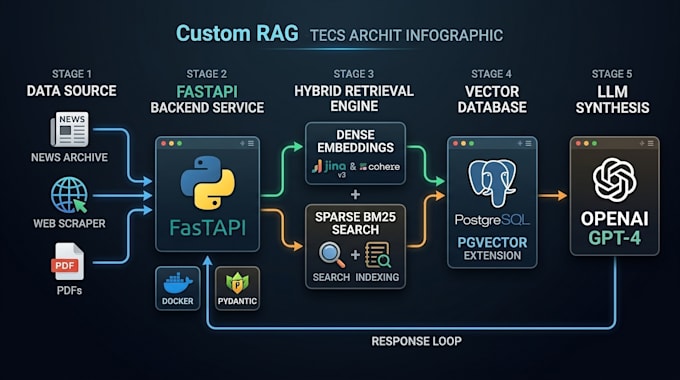
- Aangepaste RAG-architectuur: Documentchunking, embedding-generatie (Cohere, OpenAI, Jina) en vectoropslag.
- Vector-databases: PostgreSQL (pgvector), Pinecone of Qdrant integratie.
- Hybride zoekfunctie: Dense + Sparse zoektechniek voor maximale retrieval-precisie.
- Backend-integratie: High-performance REST API's gebouwd met Python & FastAPI.
- Autonome AI-agenten: LangGraph-workflows voor complexe, meerstaps taken.
- Schone code & documentatie: Volledig getypeerd (Pydantic), gedocumenteerd en Docker-geoptimaliseerd.
Technische stack:
Python | FastAPI | PostgreSQL / pgvector | LangChain / LangGraph | Docker | OpenAI / Cohere
Hoe we werken:
1. Neem contact met me op met je wensen voordat je een bestelling plaatst.
2. We bepalen de scope van het project, de tech stack en de opleveringen.
3. Ik bouw, test en lever het systeem met stapsgewijze instructies.
Laten we je data omzetten in een slim AI-systeem. Stuur me een bericht om te beginnen!
Software Engineer
Talen
Automatische vertaling
Automatische vertaling
Kun je het RAG-systeem op mijn server implementeren?
Ja, ik bied Docker-geoptimaliseerde setups en deploymentgidsen voor cloudplatforms zoals AWS, DigitalOcean of Hetzner.
Heb ik mijn eigen API-sleutels nodig?
Ja, je hebt je eigen API-sleutels nodig voor LLM-diensten (bijvoorbeeld OpenAI, Cohere, Anthropic). Ik kan je begeleiden bij het instellen ervan.
