Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Copy-pasten uit PDFs schaalt niet, en generieke OCR verpest tabellen. Goedkope data-entry klusjes werken totdat je het herhaalbaar, controleerbaar en wekelijks wilt laten draaien zonder jou.
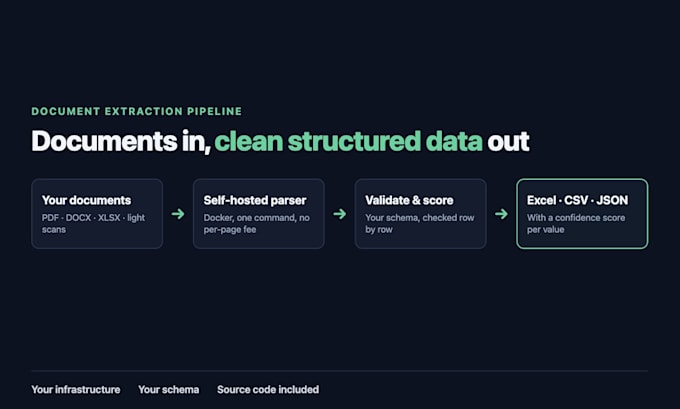
Ik bouw in plaats daarvan de pipeline: documenten erin, schone gestructureerde data eruit, op jouw eigen infrastructuur.
WAT JE KRIJGT
- Een pipeline die je zelf runt (Docker, één commando)
- Jouw schema, jouw velden, gevalideerd op elke rij
- Confidence scoring op elke geëxtraheerde waarde
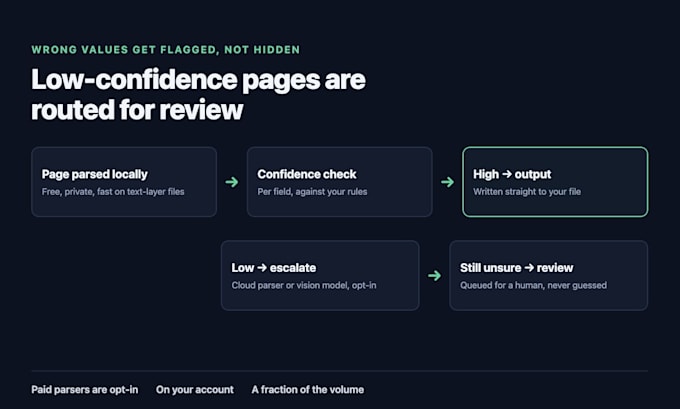
- Pagina's met lage confidence worden doorgestuurd voor review, niet stilzwijgend fout
- Excel, CSV of JSON output
- Broncode en setup-documentatie
WAAROM ZELF-HOSTEN
De parser draait lokaal: geen per-pagina kosten, en je documenten verlaten je infrastructuur nooit. Betalende cloud parsers worden alleen gebruikt voor pagina's die dat echt nodig hebben - een fractie van de volume, op jouw account, naar eigen inzicht.
HOE IK WERK
Begin met de Pilot. Stuur 20-50 echte pagina's. Ik verwerk ze en stuur een schriftelijk rapport: wat schoon geëxtraheerd is, wat niet, en welke velden reviewregels nodig hebben. Daarna beslis jij.
BINNEN SCOPE
Tekstlaag PDF, DOCX, XLSX, PPTX en lichte scans. Handwriting, formulieren en grafieken worden apart geoffreerd - vraag gerust.
Stuur 3-5 voorbeeldpagina's en de velden die je nodig hebt.
Technologie:
Excel
•
Python
Automatische vertaling
Hoe verschilt dit van een $20 data-entry klusje?
Een data-entry klusje voert je documenten één keer in. Dit is een pipeline die jij bezit en voor altijd opnieuw draait, met validatieregels en confidence scores zodat je kunt zien welke waarden je kunt vertrouwen. Een heel andere aankoop.
Betaal ik per pagina?
Niet voor de parser - die draait op je eigen machine, dus volume is gratis. Alleen pagina's die een cloud parser of vision model nodig hebben kosten iets, op jouw eigen account, en jij beslist of je dat inschakelt.
Welke nauwkeurigheid kun je beloven?
Nog niet voordat ik je documenten heb gezien, en wees sceptisch over iedereen die dat beweert. Gepubliceerde parser benchmarks verschillen enorm en resultaten hangen af van je specifieke layouts. De Pilot meet het eerst op je echte pagina's.
Verlaten mijn documenten mijn infrastructuur?
Niet standaard. De parser is zelf-gehost. Cloud parsers zijn opt-in, per pagina, en alleen voor pagina's die de lokale pipeline als laag vertrouwen markeert. Als je geen externe calls wilt, zeg dat en ik bouw het zo.
Kun je gescande documenten verwerken?
Lichte scans, ja. Zware scans, handwriting en formulieren zijn mogelijk maar kosten een aparte offerte. Ze zijn echt moeilijker, en ik prijs ze liever eerlijk dan onderpresteren.
Wat gebeurt er met waarden die fout gaan?
Ze worden gemarkeerd, niet verborgen. Elke waarde krijgt een confidence score, en rijen met lage confidence worden doorgestuurd voor review in plaats van stilzwijgend in je spreadsheet te worden geschreven.
Wie draait het na overdracht?
Jij. Het is een Docker container plus jouw code, met setup-documentatie. Eén commando om te starten.