Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Gegevensingenieur
Heb je te maken met trage queries in BigQuery, kapotte dbt-modellen of niet-geoptimaliseerde Spark-taken?
Ik ben een Senior Data Engineer (Databricks Associate Certified) met meer dan 5 jaar ervaring in het bouwen en optimaliseren van schaalbare cloud data-architecturen (GCP, Databricks, BigQuery). Ik specialiseer me in het omzetten van complexe, trage en dure data pipelines in snelle, efficiënte en kosteneffectieve workflows.
Wat ik voor jou kan doen:
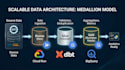
- dbt & Data Warehousing: Bouw en refactoriseer dbt-modellen volgens Medallion Architecture (Bronze, Silver, Gold), optimaliseer SQL queries en zet Cloud Run / Control-M / Airflow-uitvoeringen op.
- PySpark & Databricks: Debug, refactor en versnelling van batch ETL pipelines met Spark (Scala/Python).
- GCP Cloud Architectuur: Zet schaalbare pipelines op met BigQuery, Cloud Run en Airflow/Composer.
- Database & Query Optimalisatie: Verlaag BigQuery/Snowflake verwerkingskosten en uitvoeringstijden.
Waarom met mij werken?
- Gecertificeerde expertise: Databricks Certified Data Engineer & Azure Certified.
- Hoge kwaliteit code: Schone, modulaire en onderhoudbare data engineering praktijken.
- Duidelijke & directe communicatie: Engels en Spaans beschikbaar.
OPMERKING: Neem contact met me op met je wensen voordat je een bestelling plaatst

Tools & platforms:
Google Cloud Dataflow
•
Apache NiFi
•
Overige
Automatische vertaling
Accepteer je op maat gemaakte, lange termijn opdrachten?
Ja, maar alleen voor gescopeerde micro-taken of parttime advies. Stuur me eerst een bericht om de details te bespreken.
Wat moet ik aanleveren voordat ik begin?
Toegang tot de cloudomgeving (of geanonimiseerde voorbeeldgegevens/-codebase) en een duidelijke beschrijving van de verwachte output/foutlogs.
Kunnen we een afspraak maken voor een gesprek over het project?
Ja, via Fiverr's video call functie zodra een opdracht of verzoek is gestart.


