Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Machine Learning, NLP Specialist
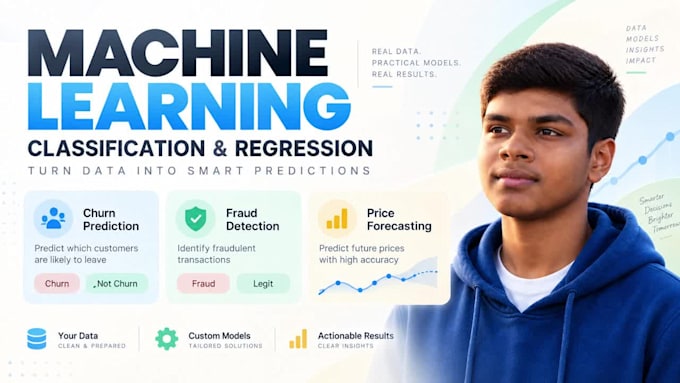
Heb je een betrouwbaar machine learning model nodig voor classificatie, regressie of voorspelling?
Portfolio: https://kawsar-portfolio-kawsar07ahmmed0712-5454.vercel.app/
Ik bouw schone, praktische machine learning oplossingen voor gestructureerde en tabelgegevens met Python.
Waar ik mee kan helpen:
Tools die ik gebruik:
Scikit-learn, XGBoost, LightGBM, CatBoost, Pandas, NumPy, Jupyter Notebook en TensorFlow indien nodig.
Je ontvangt schone source code, een getraind model, evaluatieresultaten, visualisaties en duidelijke documentatie. Standaard- en Premium-pakketten omvatten diepere tuning en modelvergelijking, terwijl Premium ook Flask API-integratie kan bevatten.
Stuur me een bericht met je dataset en projectdoel voordat je bestelt, zodat ik het juiste pakket kan aanbevelen.
Dank je wel,
Kawsar Ahmmed




Programmeertaal:
Python
•
SQL
•
Colab
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
•
Overige
Tools:
Jupyter-notitieboek
•
tensorflow
•
Excel
•
Colab
Automatische vertaling
Met welke soorten datasets kun je werken?
Ik werk vooral met gestructureerde of tabelgegevens zoals CSV- en Excel-bestanden met numerieke of categorische features. Als je niet zeker weet of je dataset geschikt is, stuur me dan gerust een bericht voordat je bestelt.
Moet ik weten of mijn probleem classificatie of regressie is?
Nee. Leg gewoon uit wat je wilt voorspellen, en ik bekijk je target variabele en adviseer de meest geschikte machine learning aanpak.
Hoe kies je het juiste machine learning model voor mijn data?
Ik vergelijk geschikte algoritmes op basis van je dataset, probleemtype en evaluatiemetrics. Afhankelijk van het project gebruik ik modellen zoals Logistic of Linear Regression, Random Forest, XGBoost, LightGBM, CatBoost, SVM of KNN.
Wat ontvang ik bij mijn bestelling?
Afhankelijk van het pakket ontvang je schone Python source code, een Jupyter Notebook, preprocessing workflow, getraind model, evaluatieresultaten, relevante visualisaties en modeldocumentatie.
Kun je werken met rommelige of ongebalanceerde datasets?
Ja. Ik kan omgaan met veelvoorkomende problemen zoals ontbrekende waarden, categorische features, schaling, feature engineering en klasse-imbalances met geschikte preprocessing technieken.
Kun je een specifieke nauwkeurigheid of prestatie score garanderen?
Geen vaste nauwkeurigheid kan worden gegarandeerd omdat de prestaties van het model afhangen van de kwaliteit, grootte, balans en voorspellende informatie in de dataset. Ik gebruik geschikte validatie, metrics en optimalisatiemethoden om een betrouwbare uitkomst te behalen.
Bied je API-integratie voor het getrainde model?
Ja. Het Premium pakket kan Flask API-integratie omvatten zodat het getrainde model input kan accepteren en voorspellingen kan teruggeven via een API. Cloud deployment is niet inbegrepen tenzij apart overeengekomen.