Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD

Automatische vertaling
Ben je op zoek naar een enterprise-grade AI chatbot om je PDFs, documenten of kennisbank met hoge nauwkeurigheid te raadplegen? Ik bouw op maat gemaakte, end-to-end Retrieval-Augmented Generation (RAG) applicaties met Python en moderne AI-tools.
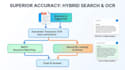
WAT JE KRIJGT: Geavanceerde hybride zoekfunctie: Combineert BM25 trefwoordmatching met neural re-ranking (Cohere) voor maximale retrieval nauwkeurigheid.
Ondersteuning voor gescande PDFs: Automatische fallback naar Tesseract OCR voor documenten met veel afbeeldingen of gescande bestanden.
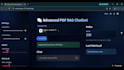
Op maat gemaakte UI: Modern, responsief Streamlit dashboard met aanpasbare donkere/navy thema's en hyperparameter controls.
Inline bronvermeldingen: Nauwkeurige antwoordgeneratie met directe bestandsnaam en paginalevens toewijzingen.
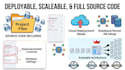
Schoon broncode: Volledig gedocumenteerde, modulaire Python code klaar voor cloud deployment.
TECH STACK: Python | Streamlit | PyMuPDF | Tesseract OCR | OpenAI API | Cohere | Vector Databases
Stuur me een bericht of plaats je bestelling vandaag nog om je complexe documenten om te zetten in een interactieve AI-assistent!
Live demo preview beschikbaar!
Stuur me een bericht om de interactieve Streamlit RAG app in real time te testen
Python Developer for RAG Chatbots, LangChain, and AI Agents
Talen
Automatische vertaling
Automatische vertaling
Heb ik mijn eigen API-sleutels nodig?
Ja, je hebt je eigen Groq en Cohere API-sleutels nodig, die gratis te verkrijgen zijn. Ik begeleid je bij het instellen ervan.
Kan deze app gescande image PDFs verwerken?
Ja, de app bevat automatische Tesseract OCR fallback om tekst uit gescande documenten te halen en te indexeren.


