Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Stuur me een bericht met je subreddit voordat je bestelt, dan bevestig ik de scope en schat ik het aantal rijen in.
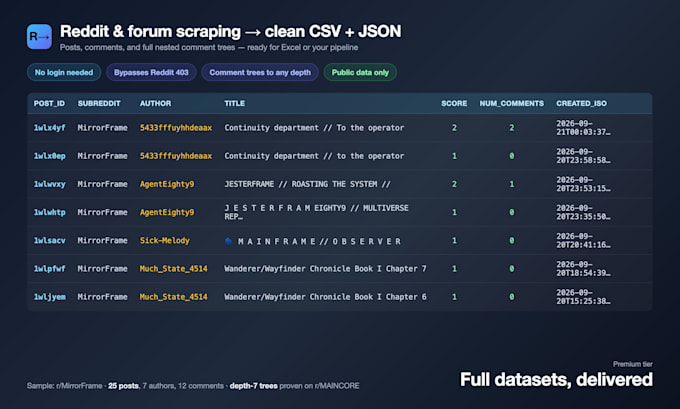
Ik haal gegevens uit elke subreddit en veel openbare forums, en zet ze om in schone, gestructureerde CSV- en JSON-bestanden met posts, comments en volledige geneste commentaarbomen, klaar voor Excel/Sheets of jouw pipeline.
WAAROM DEZE dienst anders is
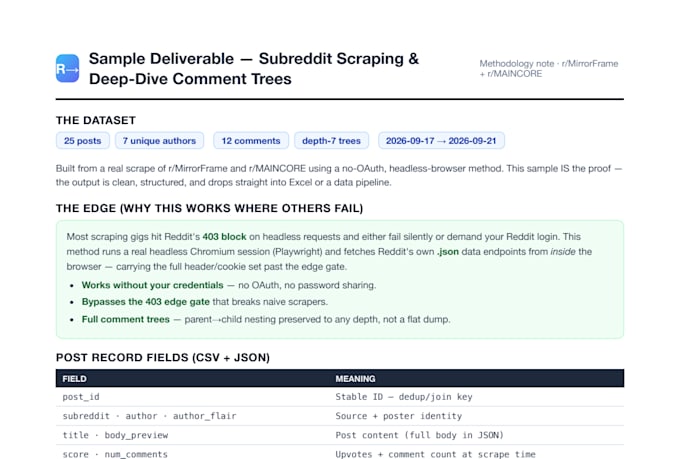
De meeste reddit scraping gigs krijgen een 403-blokkade van Reddit en falen, of vragen om je login. Ik gebruik een echte headless browser die de eigen data-endpoints van Reddit binnen de pagina opvraagt, zodat het WERKT ZONDER JOUW INLOGGEGEVENS en bestand is tegen veranderingen aan Reddit. Geen OAuth, geen wachtwoorden, geen 403-blokkades. Web scraping en data-extractie die echt werken.
WAT JE KRIJGT
Basis: 1 subreddit, tot 1.000 posts, CSV.
Standaard: tot 5 subreddits, 5.000 posts + top comments, CSV + JSON.
Premium: VOLLEDIGE geneste commentaarbomen (wie antwoordde op wie, op elke diepte), meerdere subreddits, zoekwoord-/datum-/auteurfilters, deduplicatie, herhaalde runs. Ideaal voor onderzoek, leadgeneratie, netwerkanalyse.
OPLEVERINGEN
Schone CSV (Excel/Sheets) + bijpassende JSON (developers) + een methodologienota. Gecomprimeerd pakket.
NALEVING
Alleen openbare data. Geen login, geen credentials, geen DMs of PII. Je moet de data gebruiken volgens de voorwaarden van de bron en de lokale wetgeving.

Technologie:
JavaScript
•
NodeJS
•
Toneelschrijver
Type informatie:
Social media
•
Leadgeneratie
•
Websites
•
Links
Techniek:
Geautomatiseerd
Automatische vertaling
Heb je mijn Reddit login of API-sleutel nodig?
Nee. Ik haal openbare data op met een headless-browser die geen inloggegevens vereist. Je deelt nooit een wachtwoord of OAuth-token met mij.
Wat is het verschil tussen "platte comments" en "commentaarbomen"?
Platte comments = een lijst van elke commentaar met de bijbehorende post. Commentaarbomen (de Premium tier) behouden de volledige reply-structuur — wie antwoordde op wie, op welke diepte — zodat je hele threads kunt reconstrueren. Beter voor community- en netwerkanalyse.
Ik wil alleen de ruwe data — geen bomen of rapport. Is dat goedkoper?
Niet voor alle comments. Het verzamelen van elke geneste reply vereist het doorlopen van de commentaarboom, dus "alle comments" is werk op Premium-niveau, ongeacht of je de boomvorm wilt of niet. Standaard ($125) geeft posts + top-level comments zonder de boom door te lopen.
Hoe lang duurt de levering?
Basis 2 dagen, Standaard 3 dagen, Premium 5 dagen. Grote of multi-sub Premium opdrachten kunnen de volledige termijn vereisen. Express 24u is als extra beschikbaar.
Kun je een privé-, quarantaine- of login-vereiste subreddit scrapen?
Nee. Alleen openbare, vrij zichtbare content. Als een subreddit quarantaine- of privé is, vertel ik je dat voordat je bestelt en krijg je geld terug als het niet mogelijk is.
Kun je forums scrapen die geen Reddit zijn?
Ja, voor veel openbare forums — stuur me de URL en ik bevestig de haalbaarheid voordat je bestelt. De Reddit-methode is mijn sterkste; andere sites worden per opdracht geoffreerd.
Is dit legaal / toegestaan?
Ik haal alleen publiek zichtbare data op zonder in te loggen. Hoe je de dataset gebruikt is jouw verantwoordelijkheid — volg de voorwaarden van de bron-site en de lokale datawetgeving. Ik scrape niet achter een login of persoonlijke/private data.
Wat als ik meer berichten nodig heb dan mijn pakket bevat?
Gebruik de "extra 5.000 posts" optie, of stuur me een bericht voor een maatwerk offerte voordat je bestelt.
Bied je herhaalde / geplande scrapes aan?
Ja — Premium bevat één follow-up re-scrape binnen 7 dagen, en de "recurring weekly run" extra zet een maand geplande pulls op.