Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Gegevensingenieur
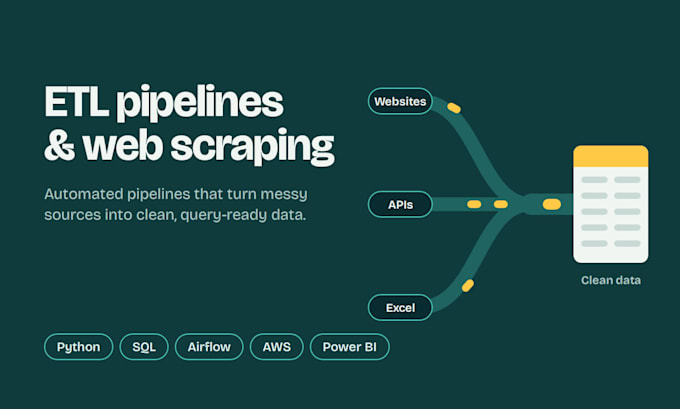
Heb je data nodig van websites, of heb je data maar geen betrouwbaar systeem om het te verplaatsen? Spreadsheets, APIs en databases die nooit op één lijn liggen, rapporten die elke week handmatig opnieuw worden opgebouwd, pijplijnen die overnight kapot gaan? Dat los ik op.
Ik ben een Data Engineer met 4 jaar ervaring en een MSc in Big Data Analytics uit het VK. Ik bouw momenteel productie-pijplijnen voor grote online marktplaatsen, inclusief incrementele Redshift-fact-tabellen met meer dan 20M records.
Wat ik bouw:
Waarom ik? echte productie-ervaring, nette gedocumenteerde code die jij bezit, en duidelijke updates bij elke stap.
Stuur me alsjeblieft een bericht voordat je bestelt zodat ik jouw project goed kan afbakenen.
Automatische vertaling
Met welke tools werk je?
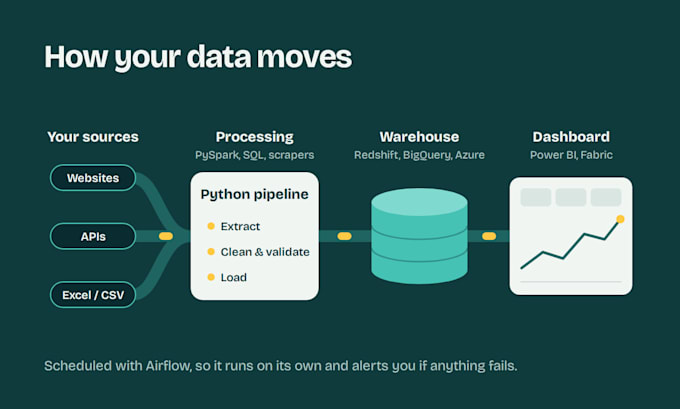
Python, SQL, PySpark, Apache Airflow, Matillion, Talend, AWS (Redshift, Lambda), Azure, Google BigQuery en Power BI, plus BeautifulSoup, Requests, Selenium, Scrapy en Playwright voor web scraping.
Kun je websites scrapen die inhoud laden via JavaScript?
Ja. Voor dynamische sites gebruik ik browser-automatiseringstools zoals Selenium of Playwright in plaats van simpele pagina-aanvragen.
Kun je werken met mijn bestaande pipeline?
Ja. Ik kan pijplijnen debuggen, optimaliseren of uitbreiden die jij al hebt, inclusief het oplossen van dubbele of ontbrekende records.
In welk formaat krijg ik mijn data?
CSV, Excel, JSON, Google Sheets, of rechtstreeks in jouw database of datawarehouse geladen.
Ben ik de eigenaar van de code?
Ja. Je krijgt de volledige broncode, en Standard en Premium bevatten ook documentatie.
Scrap je elke website?
Ik scrapes alleen publiek beschikbare data. Ik scrape geen sociale media of iets achter een login zonder toestemming, omdat dit tegen de regels van Fiverr ingaat.
Kun je real-time pijplijnen bouwen?
Geplande batch-pijplijnen zijn mijn core aanbieding. Voor real-time behoeften berichten we eerst en controleren we of het past.