Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Automatische vertaling
Jouw RAG-chatbot zag er in de demo prima uit. Toen begonnen echte gebruikers echte vragen te stellen, en nu geeft hij verkeerde antwoorden met volle overtuiging.
Meestal is het model niet het probleem. Het ligt aan retrieval, chunking, of tekst die uit OCR gebrekkig is. Ik ontdek welk deel het is, met cijfers in plaats van gissingen.
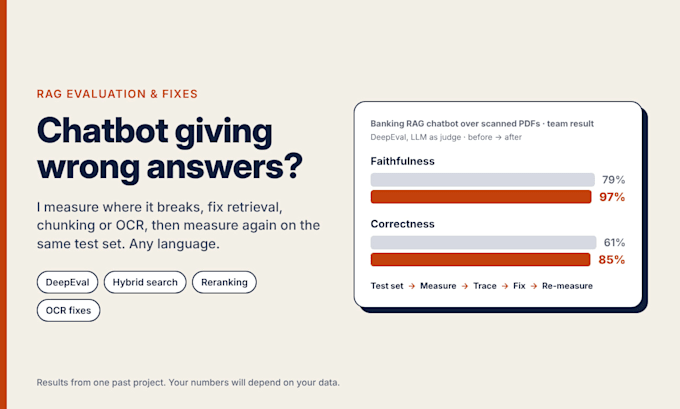
Dit is het werk waar ik het beste in ben. Bij een banking chatbot op gebonden PDF’s bij GBG zaten we op 79% trouwheid. Nadat we OCR hadden verbeterd en hybride search, reranking en query-herformulering hadden toegevoegd, kwam het op 97%, en de nauwkeurigheid ging van 61% naar 85% (DeepEval, LLM als rechter).
Hoe het werkt:
1. Ik maak een testset van jouw documenten en echte gebruikersvragen
2. Ik beoordeel trouwheid, nauwkeurigheid en retrieval-kwaliteit
3. Ik traceer elke fout naar de oorzaak: parsing, chunking, search, ranking of prompt
4. Jij krijgt een fixplan, of ik voer de aanpassingen door en beoordeel opnieuw
Je krijgt een kort rapport met voor en na cijfers op dezelfde testset. Ik beloof geen specifiek getal, omdat het afhangt van jouw data.
Werkt met LangChain, LlamaIndex of gewone Python-pijplijnen, in elke taal waarin jouw documenten zijn geschreven.
Stuur me een paar voorbeelden van slechte antwoorden. Dat is vaak genoeg om te vertellen waar ik als eerste naar kijk.
AI Engineer building RAG systems, LLM agents and Arabic NLP
Talen
Automatische vertaling
Automatische vertaling
Heb je toegang tot mijn code nodig?
Voor de audit is een werkende API-endpoint of leesrechten genoeg. Om fixes door te voeren heb ik de code nodig, bij voorkeur een privé Git-repo waar je mij uitnodigt. Ik heb geen productie-wachtwoorden nodig.
Kun je een specifieke nauwkeurigheidswaarde beloven?
Nee, en ik zou voorzichtig zijn met iemand die dat wel belooft. Het hangt af van jouw documenten en vragen. Wat ik wel beloof is eerlijke voor- en na-scores op dezelfde testset, zodat je precies ziet wat is verbeterd.
Welke tools gebruik je voor evaluatie?
Grotendeels DeepEval met een LLM-rechter, plus controles of de juiste chunks zijn opgehaald. Als je al RAGAS gebruikt of je eigen setup hebt, kan ik daarmee werken.
Maakt de taal van mijn documenten uit?
Het proces blijft hetzelfde. Taal beïnvloedt vooral OCR, tekstverdelen en zoekkwaliteit, en ik controleer die aspecten specifiek. Ik heb het meeste gewerkt met Arabisch en Engels. Zeg me jouw taal en ik zeg eerlijk of het past.
Wat als de echte oplossing een andere architectuur vereist?
Dan geeft het rapport dat aan, met een ruwe schatting, voordat ik ook maar iets aan code schrijf. Jij beslist wat er vervolgens gebeurt.
