Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Data Engineer of Pipeline Data Architect
Zoek je een schaalbare, betrouwbare en productieklare datapijplijn voor jouw bedrijf? Ik kan helpen.
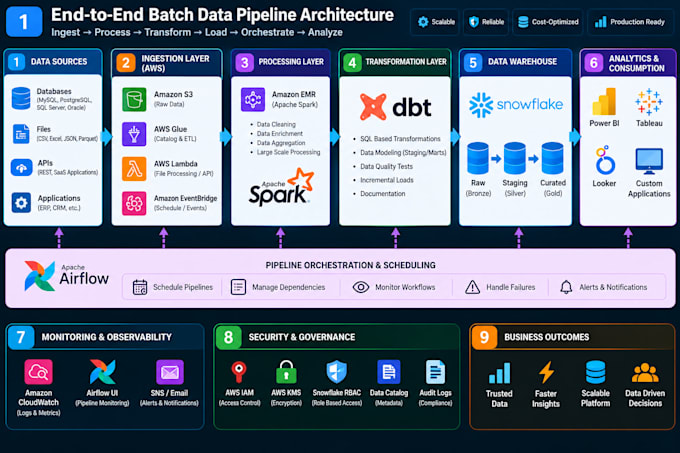
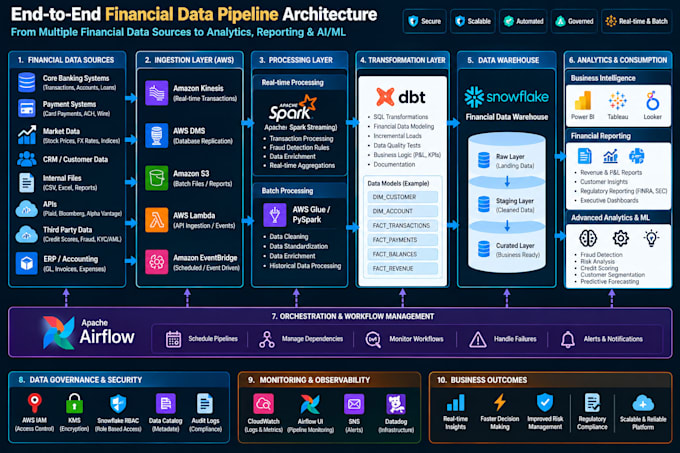
Ik ben een onafhankelijke Data Engineer die gespecialiseerd is in het bouwen van end-to-end cloud datapijplijnen die jouw data efficiënt verplaatsen, transformeren, orkestreren en organiseren.
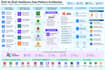
Ik kan complete data-engineeringoplossingen ontwerpen en implementeren, inclusief data-inname, ETL/ELT-pijplijnen, data-transformatie, workflow-orkestratie, gedistribueerde gegevensverwerking en cloud datawarehousing.
Mijn kerntechnologiestapel bestaat uit AWS, Snowflake, dbt, Apache Spark, Databricks en Apache Airflow. Ik richt me op oplossingen die geautomatiseerd, onderhoudbaar, schaalbaar zijn en afgestemd op jouw specifieke bedrijfsvereisten.
Of je nu een nieuwe datapijplijn vanaf nul nodig hebt, een bestaand workflow wilt moderniseren, meerdere databronnen wilt koppelen of een cloudgebaseerd dataplatvorm wilt bouwen, ik ontwikkel een oplossing van begin tot eind.
L let's turn jouw ruwe data om tot een betrouwbare, georganiseerde en analytics-klaar dataplaatvorm.
Automatische vertaling
Welke typen datapijplijnen kun je bouwen?
Ik kan end-to-end ETL/ELT-pijplijnen bouwen voor batch- of near real-time data, inclusief data-inname, transformatie, verwerking, orkestratie en cloud datawarehousing.
Met welke technologieën werk je?
Mijn belangrijkste stack omvat AWS, Snowflake, dbt, Apache Spark, Databricks en Apache Airflow.
Kun je een data pipeline vanaf nul bouwen?
Ja. Ik kan een complete pijplijn ontwerpen en implementeren op basis van jouw databronnen, bedrijfsvereisten, architectuur en schaalbaarheidsbehoeften.
Kun je werken met mijn bestaande data pipeline?
Ja. Ik kan bestaande pijplijnen opsporen, optimaliseren, automatiseren en verbeteren voor betere betrouwbaarheid, prestaties en onderhoudbaarheid.
Kun je meerdere gegevensbronnen verbinden?
Ja. Ik kan pijplijnen ontwerpen die data uit databases, bestanden, cloudopslag, API's en andere ondersteunde bronnen opnemen en verwerken.
Wordt de oplossing schaalbaar?
Ja. Ik volg een schaalbare cloudarchitectuur en ontwerp pijplijnen die kunnen omgaan met toenemende datavolumen en verwerkingsvereisten.
Heeft u documentatie?
Ja. Ik lever duidelijke documentatie met de pijplijnarchitectuur, workflow, configuratie en implementatiedetails.
Wat heb je van mij nodig om te beginnen?
Ik heb jouw projectvereisten, databronnen, verwachte output, voorkeurscloudomgeving en eventuele bestaande architectuur of code nodig om mee te werken.