Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
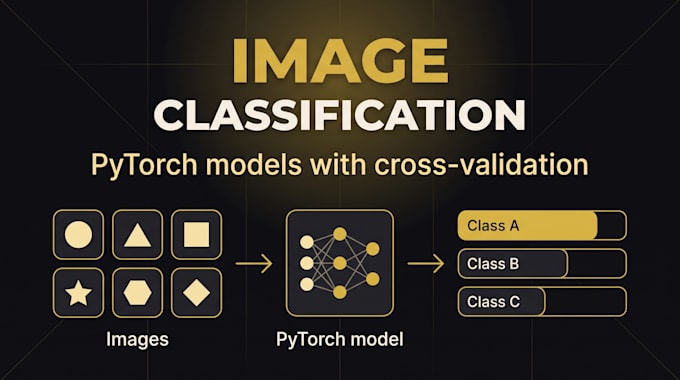
Wil je dat je beelden automatisch worden gesorteerd? Ik train PyTorch beeldclassificatiemodellen en evalueer ze eerlijk, zodat je weet hoe ze presteren op data die ze nog niet hebben gezien.
Elk pakket bevat data preprocessing, een fijn afgesteld model, testen op uitgestelde data, broncode en documentatie.
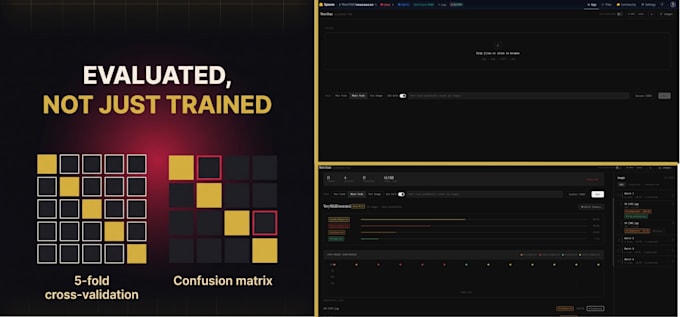
Mijn eigen project, NeuroScan, classificeert 6400 MRI-scans in 4 klassen met 98,95% gemiddelde macro recall over 5-voudige cross-validatie (alleen onderzoek, geen klinisch hulpmiddel).
Modellen: Basic 1, Standaard tot 2, Premium tot 3. PyTorch standaard; TensorFlow, Keras of object detection op aanvraag.
Jij levert een gelabelde dataset (tot ongeveer 2000 / 10.000 / 20.000 beelden per pakket). Ik train op Colab; voor een grotere GPU regel je toegang of dekt de kosten. Hostingkosten zijn voor jou. Ik kan geen specifieke nauwkeurigheid beloven, omdat resultaten afhangen van jouw data.
Stuur me een bericht met wat je wilt classificeren en een datavoorbeeld, en ik adviseer je een pakket.


Automatische vertaling
Wat voor beelden en taken kan je aan?
Elke beeldset met labels die je kunt sorteren in klassen: producten, documenten, defecten, planten, scans en meer. Eén label per beeld werkt het beste. Multi-label, segmentatie en objectdetectie zijn andere taken, dus neem eerst contact op.
Wat moet ik aanleveren?
Een gelabelde dataset, bij voorkeur één map per klasse of een CSV met beeldpaden en labels, plus een korte uitleg over hoe het model wordt gebruikt. Een ruwe richtlijn is minimaal 100 beelden per klasse. Datasetvalidatie is inbegrepen in Premium, of als extra beschikbaar.
Kun je een bepaalde nauwkeurigheid garanderen?
Nee. Resultaten hangen af van de kwaliteit van je data, labelkwaliteit, klassebalans en taakmoeilijkheid. Ik rapporteer eerlijke cijfers op onzichtbare data, en ik vertel je vroegtijdig als de data te zwak lijkt voor het doel.
Wat is cross-validatie en waarom is het belangrijk?
In plaats van één keer testen op een enkele split, wordt de data in 5 delen gesplitst en wordt het model 5 keer getraind en getest. Je krijgt een gemiddelde en een spreiding, wat laat zien of een goede score geluk was. Ik voeg dit toe vanaf het Standaard pakket.
Wat als sommige klassen veel minder beelden hebben dan andere?
Dat komt vaak voor. Vanaf Standaard gebruik ik technieken zoals focal loss en class weighting, en beoordeel ik het model op metrics zoals macro recall, niet alleen op algehele nauwkeurigheid, zodat zeldzame klassen niet worden genegeerd.
Welke frameworks en modellen gebruik je?
PyTorch standaard, met bewezen pretrained backbones (bijvoorbeeld ResNet, EfficientNet of een Vision Transformer) fijn afgesteld op jouw data. TensorFlow of Keras is op aanvraag beschikbaar; laat het me weten voordat je bestelt zodat ik de geschiktheid kan bevestigen.
Wat krijg ik, en wat betekent monitoring?
Modelgewichten, broncode, een gedocumenteerde pipeline en jouw resultaten. Standaard bevat MLflow performance tracking en een FastAPI endpoint in Docker; Premium voegt voorspelling en latency logging toe plus een walkthrough call. Monitoring betekent tracking en logging, niet live dashboards of alerts.
Host je het model of de API?
Ik verzorg geen hosting. Premium omvat het deployen van de API naar jouw cloud account, server of een Hugging Face Space; je geeft me toegang en betaalt de hostingkosten. Standaard levert een Docker image dat je zelf kunt deployen.
Kan ik het gebruiken voor medische of veiligheidskritische beslissingen?
Nee. Mijn modellen zijn gebouwd voor algemeen beeldsorteren en onderzoek. Mijn NeuroScan project is een onderzoeksdemo, geen klinisch hulpmiddel. Alles medisch of veiligheidskritisch vereist goede validatie en regelgevende goedkeuring buiten deze dienst.
Wat als ik niet tevreden ben met de resultaten?
Fouten in wat ik heb geleverd worden gecorrigeerd via jouw revisies (1 in Basic, 2 in Standaard, 3 in Premium). Resultaten hangen af van je data, dus verbeteren met meer data, extra modellen of langere tuning is een nieuwe opdracht of extra.