Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
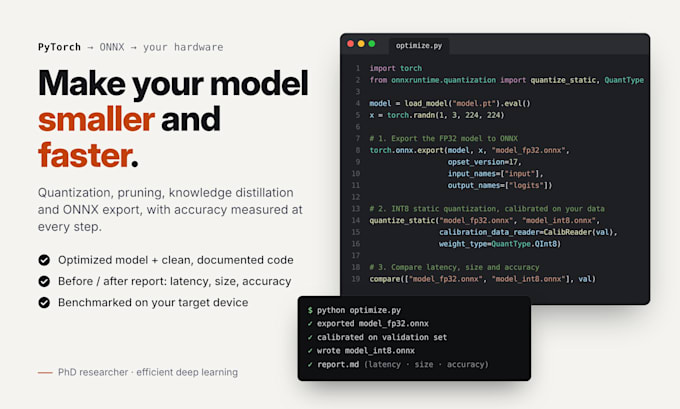
Is jouw PyTorch-model te traag, te groot of te duur om in productie te draaien? Ik ben een PhD-onderzoeker op het gebied van computer vision met peer-reviewed publicaties over modelcompressie en knowledge distillation. Ik maak jouw model kleiner en sneller terwijl de nauwkeurigheid onder controle blijft.
Wat ik kan doen:
Wat je krijgt:
Stuur me voor het bestellen een bericht met jouw modelarchitectuur, framework-versie, doelhardware (GPU, CPU, Jetson, mobiel) en nauwkeurigheidsbudget, zodat ik het juiste pakket kan bevestigen.
Programmeertaal:
Python
•
Colab
Tools:
Jupyter-notitieboek
•
opencv
•
PyTorch
Frameworks:
keras
•
PyTorch
Automatische vertaling
Zal de optimalisatie de nauwkeurigheid van mijn model verminderen?
Sommige technieken kosten een beetje nauwkeurigheid. We stemmen vooraf een nauwkeurigheidsbudget af voordat ik begin; ik meet elke stap en jij krijgt voor/na-cijfers, zodat er geen verrassingen zijn.
Welke modellen en frameworks ondersteun je?
Vooral PyTorch-visionmodellen: classificatie, detectie, segmentatie en soortgelijke taken. TensorFlow/Keras-modellen kunnen vaak via ONNX worden verwerkt. Als jouw model iets bijzonders is, stuur me eerst een bericht en vertel ik eerlijk of ik kan helpen.
Heb je mijn trainingsdata nodig?
Quantisatie en ONNX-exporteren hebben maar een kleine calibratie/validatieset nodig. Distillatie en fine-tuning vereisen toegang tot trainingsdata. Jouw model, code en data blijven vertrouwelijk en worden nooit hergebruikt.
Op welke hardware test je het?
Ik voer benchmarks uit op NVIDIA RTX-GPU's (TensorRT, ONNX Runtime GPU), x86 CPU's, Apple Silicon Macs en Android-telefoons. Voor Jetson of andere edge-boarden lever ik het geëxporteerde model plus een benchmarkscript dat jij kunt draaien, of ik test met toegang die jij biedt.
Wat krijg ik precies?
De geoptimaliseerde modelbestanden (bijvoorbeeld ONNX of een TensorRT-engine), schone Python-code die elke stap reproduceert en een korte rapportage met latency voor/na, modelgrootte en nauwkeurigheid.
