Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
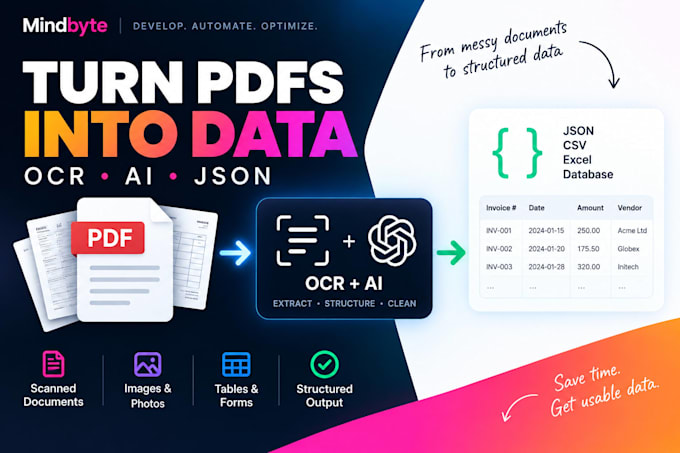
Ik bouw OCR- en documentverwerkingspijplijnen die PDFs, scans en afbeeldingen omzetten in gestructureerde, bruikbare data.
Ik kan tekst, tabellen, data, referenties, IDs en aangepaste velden extraheren, documenten classificeren, de resultaten opschonen en gestructureerde JSON, CSV of database-klare output teruggeven.
Afhankelijk van het project kan ik ook APIs, asynchrone verwerking, semantisch zoeken of RAG-workflows bouwen.
Mijn focus ligt op betrouwbare, herbruikbare documentverwerking in plaats van eenvoudige eenmalige PDF-conversies.
Stuur alsjeblieft representatieve voorbeeldbestanden voordat je complexe projecten bestelt.
Technologie:
Python
Automatische vertaling
Kun je gescande PDFs verwerken?
Ja. Ik kan gescande PDFs en afbeeldingen verwerken, inclusief preprocessing indien nodig.
Kun je specifieke velden extraheren?
Ja. Data, ID's, referenties, titels, documenttypes en andere velden kunnen worden geëxtraheerd.
Kun je documenten classificeren?
Ja. Classificatie kan worden gedaan met regels, machine learning of AI, afhankelijk van de use case.
Kun je tabellen extraheren?
Ja, afhankelijk van de layout van het document en de scankwaliteit.
Kun je een API bouwen rond de pipeline?
Ja. REST API en achtergrondverwerking kunnen worden toegevoegd.
Kun je grote volumes verwerken?
Ja, maar grootschalige workflows vereisen meestal een aangepaste scope.
