Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
AI-ingenieur
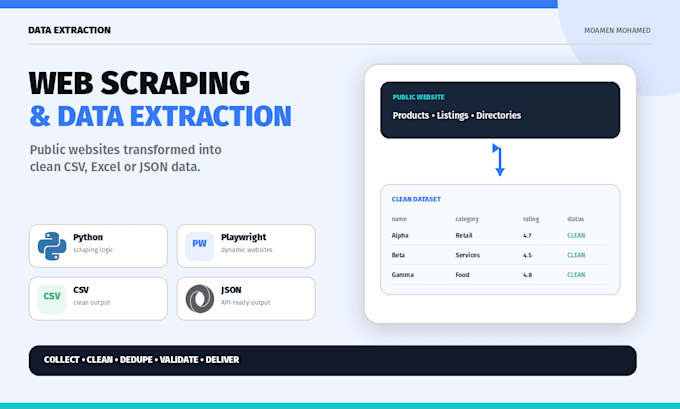
Wil je schone web data in plaats van een breekbare kopieer-en-plak dump? Ik lever gevalideerde CSV-, Excel- of JSON-datasets en herbruikbare Playwright-scrapers, gebaseerd op een project met 9.699 records waarbij 35/35 steekproeven overeenkomen met de live bron.
Ik gebruik Python, Requests en Playwright voor productpagina's, openbare directories, lijsten, artikelen en andere geautoriseerde bronnen. De workflow kan omgaan met JavaScript-pagina's, paginering en oneindige scroll wanneer dat in het pakket is inbegrepen.
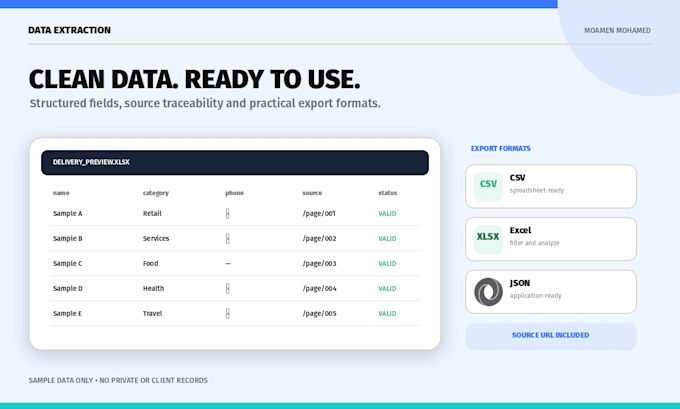
Elke levering bevat de afgesproken velden, basisreiniging, exacte de-duplication, bron-URL's indien beschikbaar en een live controle tegen de bron.
Stuur de doel-URL, velden, verwachte volume en outputformaat voordat je bestelt. Ik omzeil geen CAPTCHAs, paywalls, toegangscontroles of accountrechten. Ik verzamel geen privé-, gelekte of beschermde persoonlijke gegevens.
Proxy-, API-, account- en hostingkosten zijn niet inbegrepen.
Technologie:
Python
•
Toneelschrijver
•
Pandas
Type informatie:
Vermeldingen
•
Producten en reviews
•
Websites
Techniek:
Geautomatiseerd
Automatische vertaling
Kun je elke website schrapen?
Nee. Ik inspecteer de site, toegangregels en technische complexiteit voordat ik de opdracht accepteer.
Omzeil je CAPTCHAs, paywalls of inlogbeperkingen?
Nee. Ik omzeil geen toegangscontroles. Een geauthenticeerde bron wordt alleen beschouwd als jij het account bezit, toegang autoriseert en het platform het gebruik toestaat.
Is de broncode inbegrepen?
Dit is inbegrepen in Standard en Premium. Basic levert alleen het dataset op.
Wat als de website minder records heeft dan de limiet van het pakket?
Ik lever de records die in de afgesproken bron bestaan. Ik verzin nooit ontbrekende records.
Maak je de data schoon?
Ja. Basisreiniging en exacte de-duplication zijn inbegrepen. Complexe verrijking, fuzzy entity matching of analyse vereist een aangepaste offerte.
Werkt de scraper voor altijd?
Geen enkele scraper kan dat garanderen omdat websites hun HTML, APIs en beveiligingen aanpassen. Ik test de geleverde versie tegen de huidige site en kan onderhoud apart aanbieden.
Is scraping legaal?
De legaliteit hangt af van de bron, jurisdictie, datatypes en het beoogde gebruik. Jij bent verantwoordelijk voor het bevestigen van je recht om de data te verzamelen en te gebruiken, en ik kan risicovolle bronnen weigeren.