Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD

Automatische vertaling
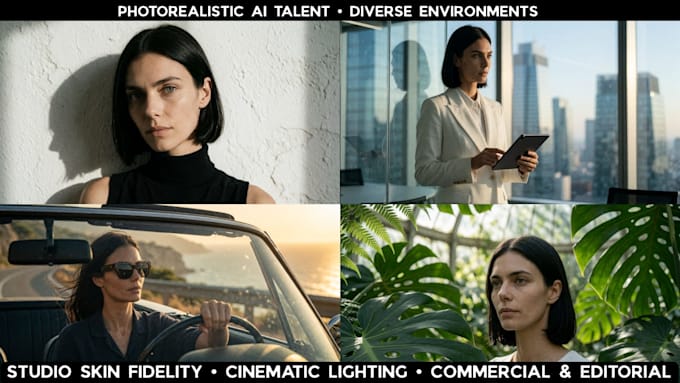
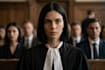
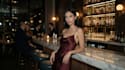
Wil je jouw aangepaste character, AI-influencer of persona meenemen in LTX-2.5 video generatie met een consistente gezichtsidentiteit?
Ik train hoogprecisie character LoRAs (.safetensors) die speciaal zijn ontworpen voor de LTX-2.5 video-pipeline in ComfyUI. In plaats van willekeurige gezichtsveranderingen krijg je een toegewijd model getraind op jouw referentiebeelden om gelijkenis te behouden bij verlichting, outfits en scènes.
Wat je krijgt:
Custom LTX-2.5 Character LoRA (.safetensors) getraind tot 2.000 stappen met nette captioning
10-seconden video voorbeelden met native gesynchroniseerd ambient geluid (16:9 of 9:16 staand)
Tested Prompt Guide: Tijdgestuurde prompt-structuur om gezichtsidentiteit te verankeren en vervorming te voorkomen
ComfyUI Workflow JSON (Premium / Gig Extra): Compleet dual-pass node-setup met aangepaste sigmas
Bestemd voor:
Virtuele AI-influencers & sociale media-content (TikTok / Reels)
Conistente karakters voor cinematische trailers & storytelling
Gevalideerde tracking shots, portretten en choreografie
Bestel nu of stuur me een bericht om jouw LTX-2.5 LoRA op maat te bouwen!
Laat het de freelancer weten als je voorkeuren voor of zorgen hebt over het gebruik van AI-tools voor het voltooien en/of leveren van je bestelling.
Create Stunning AI Characters High Quality LoRA Models
Talen
Automatische vertaling
Automatische vertaling
Hoeveel afbeeldingen heb ik nodig?
Basic accepteert tot 20 afbeeldingen, terwijl Standard tot 50 accepteert. Helder beeld met variërende hoeken, gezichten, framing en belichting is over het algemeen nuttiger dan veel bijna identieke afbeeldingen.
Ziet mijn karakter er in elke video precies hetzelfde uit?
Volledige consistentie kunnen we niet garanderen. Training is gericht op het verbeteren van herkenbare kenmerken, maar de resultaten hangen af van de dataset, prompts, modelconfiguratie en complexiteit van de beweging.
Welke bestanden ontvang ik?
Je ontvangt de getrainde LoRA-adapter in .safetensors-formaat, de trigger-woord, gebruiksaanwijzingen en de testclips die bij je pakket zitten. Het volledige LTX-2.5-basismodel zit niet inbegrepen.
Werk de adapter samen met elke LTX-versie?
De adapter is getraind voor de gespecificeerde LTX-2.5-workflow. Compatibiliteit met andere versies, checkpoints of aangepaste pipelines is niet gegarandeerd.
Wat houdt één revisie in?
Eén revisie dekt een aanpassing binnen de oorspronkelijke pakketomvang, met het afgesproken dataset en doelmodel. Een nieuw dataset, extra karakter, andere modelversie of aanzienlijk andere trainingsopdracht vereist een aparte offerte.
Mag ik de getrainde adapter commercieel gebruiken?
Gebruik en overdracht vallen onder de LTX-2.x-licentie. Ik voeg een kopie van de licentie en verplichte meldingen bij de adapter. Commerciële entiteiten met een jaarlijkse omzet van minstens $10 miljoen moeten de vereiste betaalde licentie van Lightricks verkrijgen voordat ze de adapter gebruiken.
Hoeveel referentiebeelden moet ik aanleveren?
Voor de beste resultaten lever je 20 tot 40 hoogwaardige afbeeldingen van jouw charakter. Neem een mix van close-up portretten, medium shots, verschillende hoeken (voorzijde, 3/4 profiel), varied lighting en een paar verschillende outfits zodat de LoRA het gezicht van jouw karakter leert herkennen onafhankelijk van kleding.
Dankt deze LoRA werkt in mijn lokale of cloud ComfyUI-set-up?
Ja! Je ontvangt het standaard .safetensors LoRA-bestand dat compatibel is met de LTX-2.5 22B distilled transformer in ComfyUI. Als je de exacte node-setup wilt, kies dan voor het Premium-pakket (of voeg de Workflow Extra toe) en ik voeg mijn kant-en-klare ComfyUI .json-workflow toe.
Genereert LTX-2.5 zowel 16:9 horizontaal als 9:16 verticaal video’s?
Zeker. Geef bij de bestelling jouw favoriete beeldverhouding door en ik render jouw meegeleverde voorbeeldvideo’s in 16:9 wijdbeeld (1280x720) of 9:16 verticaal (720x1280) met native ambient geluid.
Hoe voorkom ik dat het gezicht vervormt tijdens beweging?
LTX-2.5 reageert het best op continue proza en tijdgestuurde choreografie waarbij het gezicht van het personage in de openingsframe zichtbaar is. Naast jouw LoRA lever ik een op maat gemaakte prompt-sjabloon waarmee je precies leert hoe je prompts structureert voor maximale identiteitsbehoud.