Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Full Stack ontwikkeling en Machine Learning
Ben je op zoek naar een betrouwbare ontwikkelaar op het gebied van Machine Learning en Data Science om jouw data om te zetten in nauwkeurige voorspellingen en bruikbare inzichten?
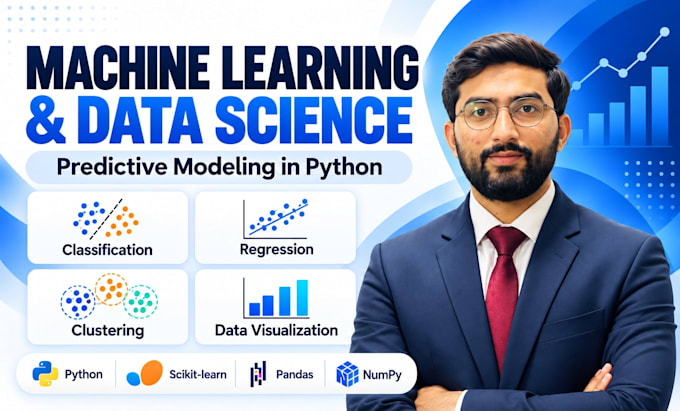
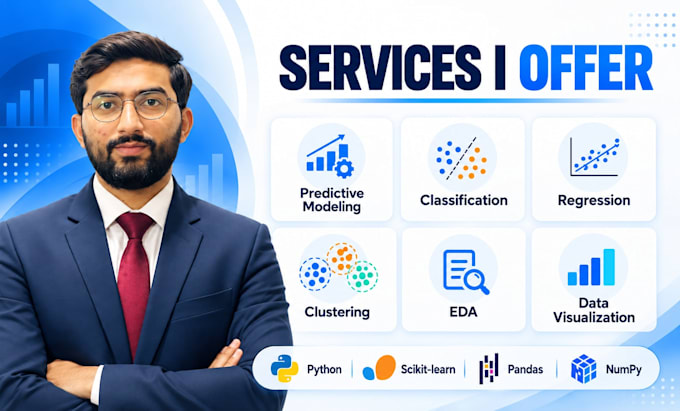
Welkom! Ik ontwikkel op maat gemaakte machine learning- en voorspellende modellijingsoplossingen met Python, Scikit-learn, Pandas en NumPy. Of je nu classificatie, regressie of voorspellende analyse nodig hebt, ik help je een praktische, databookte oplossing te bouwen.
MIJN DIENSTEN:
WAAROM MIJN DIENST TE KIEZEN?
Laten we aan de slag gaan!
Deel je dataset, projectvereisten, verwachte resultaten en deadline.
Neem voor het plaatsen van een bestelling contact met mij op!
Programmeertaal:
Python
•
Java
Frameworks:
Scikit-learn
•
keras
•
Panda
Tools:
Jupyter-notitieboek
•
Excel
•
Colab
Automatische vertaling
Welke soorten machine learning projecten kan je ontwikkelen?
Ik ontwikkel machine learning-modellen voor classificatie, regressie, voorspellende analyses en data science met Python en Scikit-learn. Ook kan ik helpen met feature engineering, modelevaluatie en data-visualisatie.
Moet ik een dataset aanleveren?
Ja, lever alsjeblieft je dataset aan of leg de beschikbaarheid, het formaat en de grootte uit. Ik kan werken met CSV, Excel en andere ondersteunde tabeldatasets. Data preprocessing is beschikbaar volgens jouw gekozen pakket.
Welke tools en technologieën gebruik je?
Ik gebruik voornamelijk Python, Scikit-learn, Pandas, NumPy, Matplotlib en relevante libraries voor data-visualisatie. Ik kies geschikte algoritmes en tools op basis van jouw projectdoelen en dataset.
Kun je een hoge voorspellingsprecisie garanderen?
Helaas is modelprestaties afhankelijk van datakwaliteit, beschikbare features, datasetgrootte en complexiteit van het probleem. Ik gebruik geschikte evaluatiemetriieken en richt me op het ontwikkelen van betrouwbare modellen in plaats van unrealistische precisie te beloven.
Ontvang ik Python-broncode en documentatie?
Ja. Ik lever de afgesproken Python-broncode en modeluitvoer. Documentatie, evaluatierapporten en extra deliverables zijn inbegrepen volgens jouw gekozen pakket of maatwerkaanbieding.
Biedt u training en ondersteuning nadat de taak is voltooid?
Zeker! Ik kan uitleggen hoe je het model draait, hoe je voorspellingen begrijpt en hoe je de geleverde code gebruikt. Verdere persoonlijke training en uitgebreide ondersteuning kun je bespreken op basis van jouw projectvereisten.