Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Data omzetten in oplossingen met precisie
Nodig een data-ingenieur in voor je ETL-pijplijnen? Airflow DAG faalt? Spark-job loopt op geheugen? Ik repareer kapotte data-pijplijnen snel, en zorg daarna dat ze niet weer kapotgaan.
Uitgeput van 2 uur 's nachts DAG-fouten? Ik voeg een AI-agent toe aan jouw Airflow + Spark-stack die fouten diagnosticeert, de veilige automatisch oplost en je een duidelijk root-cause-rapport geeft voor de rest.
Wat je krijgt:
De Tech Stack: Airflow, Spark, Kafka, NiFi, HDFS, MinIO, Agentic Frameworks.

Automatische vertaling
Hoe verschilt Agentic ETL van traditionele ETL?
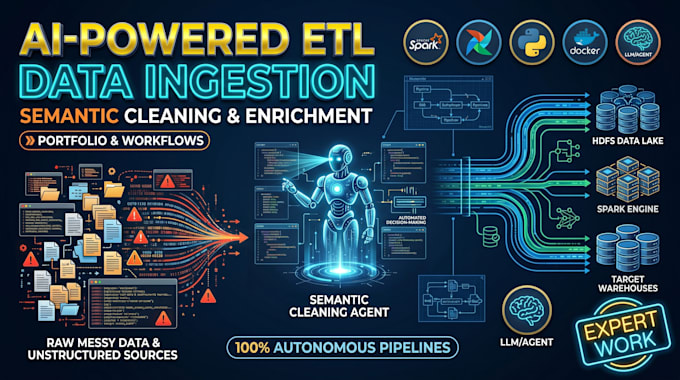
Traditionele ETL vertrouwt op rigide, hardcoded regels die breken wanneer dataformaten veranderen. Mijn Agentic ETL-pijplijnen gebruiken AI om semantisch te begrijpen, te parseren en ongestructureerde of rommelige data schoon te maken voordat ze veilig in je HDFS data lake worden geladen, waardoor de pipeline zeer veerkrachtig is.
Is mijn bedrijfsdata veilig bij het gebruik van deze AI-agenten?
Hoewel we commerciële APIs kunnen integreren, richt ik me op het inzetten van veilige, lokale LLMs (zoals Qwen, DeepSeek, agents op basis van frameworks) direct binnen jouw gecontaineriseerde omgeving. Zo blijft je gevoelige data altijd binnen je interne netwerk of cluster.
Moet ik mijn huidige infrastructuur migreren?
Nee. Ik ontwerp deze agentic workflows zodat ze naadloos integreren met je bestaande Apache Airflow en Spark setups. Alles wordt verpakt met Docker (of Docker Swarm voor hoge beschikbaarheid) zodat het direct op je huidige architectuur wordt aangesloten.
Wat gebeurt er als de agent een storing niet kan oplossen?
Het wordt doorgezet. Je krijgt een Slack- of e-mailmelding met de oorzaak, de relevante logregels en een voorgestelde oplossing. Risicovolle wijzigingen (code, schema, alles wat met productie data te maken heeft) moeten altijd jouw goedkeuring krijgen. De agent lost alleen automatisch storingen op die we als veilig hebben afgesproken.
Kun je een nieuwe ETL-pijplijn van nul af aan bouwen, niet alleen een bestaande oplossen?
Ja. Ik ontwerp en bouw end-to-end datapijplijnen: inkaging uit API's, databases of bestanden, transformatie in PySpark of Python, orkestratie in Apache Airflow en laden in PostgreSQL, S3, Hive of jouw datawarehouse.