Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Data scientist
Zoek je een ervaren Data Scientist om ruwe, rommelige data om te zetten naar
actiegerichte inzichten en nauwkeurige predictieve modellen? Je bent op de juiste plek.
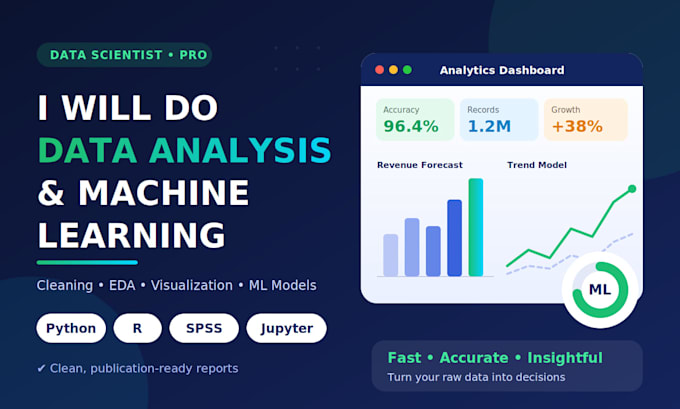
Ik ben een professionele Data Scientist met diepe kennis van Python, R en IBM
SPSS. Ik levert schone, production-ready code naast high-impact inzichten.
Wat ik Bied: Data Cleaning: omgaan met missende waarden, outliers, duplicaten,
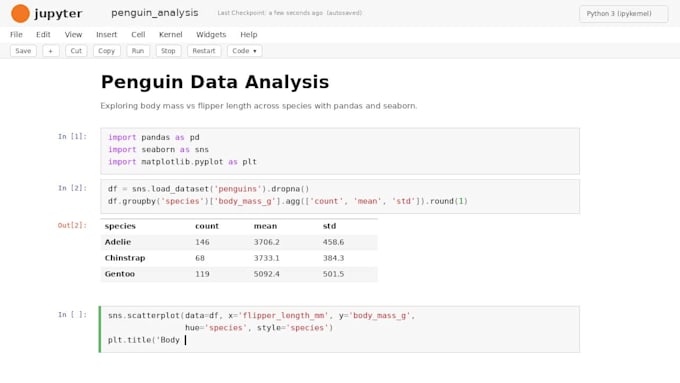
en feature engineering. EDA & Visualisatie: grondige verkennende analyse,
identificatie van trends en duidelijke grafieken (Matplotlib, Seaborn, ggplot2).
Statistische Modellering (SPSS & R): hypothesetesten (t-tests, ANOVA,
Chi-kwadraat), regressie en analyse van enquêtedata. Machine Learning
(Python/R): classificatie, regressie, clustering (Random Forest, XGBoost,
LightGBM, SVM) & modelafstemming.
Tools & Technologieën: Python | R & RStudio | IBM SPSS | Jupyter Notebook |
Pandas | NumPy | Scikit-Learn
Waarom voor mij kiezen?
- Schoone, goed gedocumenteerde reproduceerbare code
- Duidelijke visuele rapporten die de getallen toelichten
- Snelle oplevering en 100% tevredenheid gegarandeerd
Stuur me alstublieft een bericht voordat je een bestelling plaatst om je wensen en
de projectomvang te bespreken!


Automatische vertaling
Kunt u de broncode verstrekken?
Ja, absoluut. Je ontvangt volledig gedocumenteerde, leesbare en reproduceerbare broncode (Jupyter Notebook .ipynb, R Markdown of schone script).
Mijn data is vertrouwelijk. Kan ik een NDA ondertekenen?
Ja. Ik behandel alle klantgegevens met strikte vertrouwelijkheid. Indien gewenst, teken ik graag een NDA (Non-Disclosure Agreement).
Kun je werken met academische of enquêtegegevens met SPSS?
Ja. Ik heb ruime ervaring met het uitvoeren van statistische tests (t-toetsen, ANOVA, Chi-kwadraat, betrouwbaarheid) en het interpreteren van outputs in APA-formaat met IBM SPSS en R.
Wat als ik niet weet welk ML-model het beste is voor mijn probleem?
Geen enkel probleem! Deel gewoon je dataset en je bedrijfsdoel. Ik test meerdere state-of-the-art algoritmes en raad degene aan die de hoogste nauwkeurigheid en generaliseerbaarheid oplevert.