Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
IT-specialist en software-ingenieur
Niveau 2
Voldoet aan hoge prestatiecriteria en heeft een bewezen staat van dienst in het voldoen aan de verwachtingen van de klant.
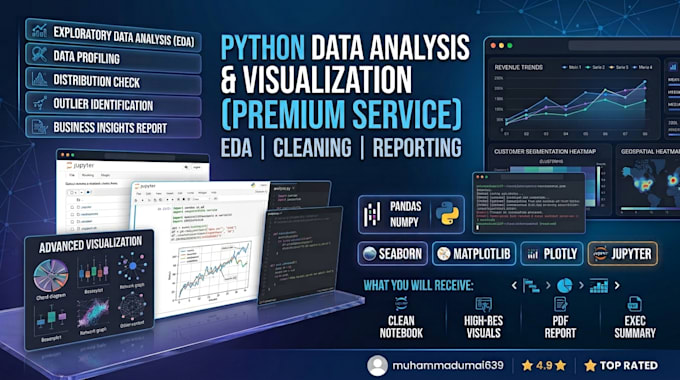
Ik schoon, organiseer en visualiseer datasets met behulp van Python's kern data science stack: Pandas, NumPy, Matplotlib en Seaborn (PySpark beschikbaar voor grotere datasets).
Wat ik doe:
Voor wie dit is: oprichters, analisten en onderzoekers die ruwe of rommelige data hebben en die willen omzetten in iets wat ze daadwerkelijk kunnen gebruiken, zoals een schone dataset, een set grafieken of een samenvatting van bevindingen voor stakeholders.
Proces: stuur je dataset en doel, ik schoonmaak/analyseer het, jij ontvangt een gedocumenteerde notebook (of presentatie op Premium) met duidelijke before/after resultaten.
Stuur me een bericht voordat je bestelt als je dataset groot is of de analyse niet-standaard, ik bespreek het graag eerst.


Programmeertaal:
Python
Technologie:
Python
•
tensorflow
•
PyTorch
•
opencv
•
keras
•
scikit-learn