Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD



Automatische vertaling
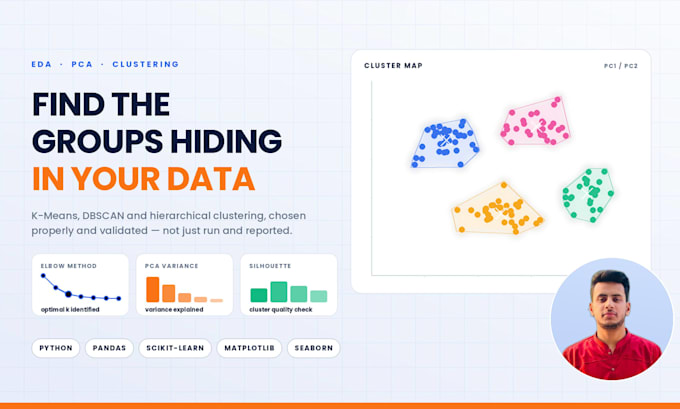
Zit je op data die je niet kunt lezen? Weet je niet zeker welke klanten je moet targeten, welke op het punt staan te vertrekken, of wat je cijfers beïnvloedt?
Daar fix ik het voor.
Stuur me je dataset en ik vind de patronen die erin verborgen zitten, en leg uit wat ze betekenen voor jouw bedrijf in eenvoudige taal, geen jargon.
Hoe ik het oplos
Wat dat voor jou betekent
Ik vertel je eerlijk wat je data kan beantwoorden en wat niet, voordat je er een euro aan uitgeeft.
Stuur me je dataset en doel. Ik bekijk het en adviseer de aanpak.
Data Scientist and Full Stack Developer
Talen
Automatische vertaling
Automatische vertaling
Welke gegevens heb je nodig om te beginnen?
Je kunt je dataset aanleveren in CSV-, Excel- of JSON-formaat. Als je data onvolledig is, kan ik ook de preprocessing verzorgen.
Welke clustering algoritmes gebruik je?
Ik gebruik K-Means, hiërarchische clustering en DBSCAN. Ik kies de beste methode op basis van jouw dataset en doelen.
Doe je ook dimensionaliteitsreductie?
Ja, ik bied PCA aan om dimensies te reduceren, clusters te visualiseren en de prestaties te verbeteren.
Kun je ook classificatiemodellen bouwen?
Absoluut. Ik kan KNN- en SVM-modellen bouwen en evalueren, afhankelijk van jouw wensen.
Krijg ik visualisaties?
Ja—clusterplots, PCA-visualisaties, correlatie-heatmaps, pairplots en meer (afhankelijk van jouw pakket).
Kunt u werken met rommelige of onvolledige gegevens?
Ja, ik verwerk ontbrekende waarden, outliers, encoding, scaling en volledige preprocessing.
Leg je de resultaten uit?
Natuurlijk. Ik bied duidelijke inzichten, interpretaties en aanbevelingen op basis van de bevindingen.
Kunt u mij de code geven?
Ja, je ontvangt schone, georganiseerde en goed commentaar Python-code (Jupyter Notebook of .py-bestand).
Kun je me helpen het juiste algoritme te kiezen?
Ja—deel je doel, en ik leid je naar de beste clustering- of classificatiebenadering.
Hoe waarborgt u de privacy en veiligheid van gegevens?
Jouw data wordt strikt vertrouwelijk behandeld. Ik deel, hergebruik of bewaar je bestanden nooit langer dan nodig is voor het project. Alles blijft veilig en wordt direct verwijderd na oplevering op verzoek.