Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
AI Engineer: LLM Agents, RAG, Document AI : Computer Vision en Video Analytics
Niveau 1
Voldoet aan bepaalde prestatiecriteria en toont een sterke potentie op de marktplaats.
Nog steeds iemand betalen om data uit facturen, bonnetages of formulieren met de hand te typen?
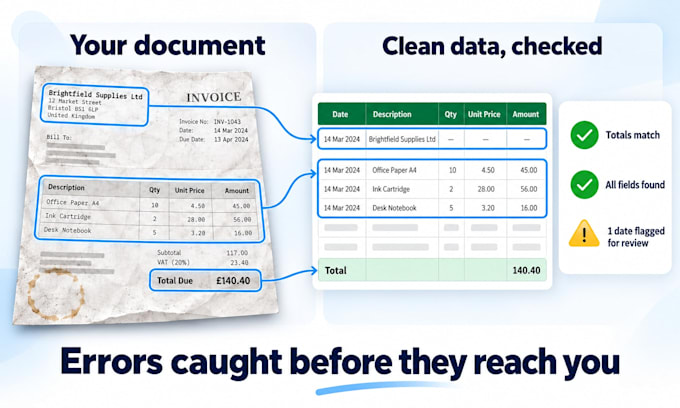
Ik bouw AI OCR-systemen die jouw documenten lezen en schone, gestructureerde data rechtstreeks naar Excel, Google Sheets, jouw database of jouw app teruggeven.
WAT IK EXTRAGE
- Facturen en bonnetjes: regels, totalen, data, btw, leveranciersgegevens
- Bankafschriften, purchase orders en leveringsbewijzen
- Identiteits- en KYC-documenten: paspoorten, vergunningen, nationale ID-kaarten
- Contracten en formulieren: velden, handtekeningen, vakjes
- Handgeschreven en slechter gescande pagina's
- Tabellen, zelfs als ze over meerdere pagina's lopen
WAAROM HET ANDERS IS
Elke klus bevat validatieregels die fouten vangen voordat ze bij jou terecht komen: totalen die niet kloppen, ontbrekende velden, onmogelijke data. Je krijgt ook een nauwkeurigheidsrapport gebaseerd op JOUW documenten, niet op een demo.
STACK: Python, PaddleOCR, Tesseract, AWS Textract, Google Document AI, Azure Document Intelligence, vision LLMs.
Twijfel je of het werkt op jouw documenten?
Stuur me 2 of 3 voorbeelden en de velden die je nodig hebt voor aankoop. Ik vertel je eerlijk welke nauwkeurigheid je kunt verwachten.

Technologie:
Excel
•
Google Sheets
•
Python
•
Zapier
•
Overige
Automatische vertaling
Werkt dit op mijn specifieke documenten?
Dat is precies waarvoor het Proof of Concept pakket bedoeld is. Stuur 3-5 van je echte documenten en ik voer de extractie uit en laat je de resultaten zien met een nauwkeurigheidsrapport voordat je je aan iets groters verbindt. Als je documenten niet goed passen, weet je dat voor een klein bedrag.
Welke nauwkeurigheid kan ik verwachten?
Het hangt af van je documenten, en iedereen die je een prijs geeft voordat ze ze hebben gezien, raadt maar wat. Schone digitale PDFs met consistente layouts behalen meestal zeer hoge nauwkeurigheid. Slechte scans, handschrift en sterk variërende layouts zijn moeilijker. Daarom bevat elk pakket een nauwkeurigheidsrapport dat de meetmethode beschrijft.
Krijg ik de broncode en een werkende API?
Ja, vanaf het Standard pakket. Je krijgt de volledige broncode, en het Premium pakket bevat een API plus deployment naar je eigen server, gecontaineriseerd met Docker, en documentatie zodat je team het zelf kan onderhouden.
Zijn mijn documenten vertrouwelijk? Is mijn data veilig?
Ja, en ik zal er duidelijk over zijn. Ik heb alleen voorbeeld documenten nodig, en je kunt gevoelige waarden verwijderen voordat je ze stuurt. Als je documenten helemaal niet door een derde partij verwerkt kunnen worden, kan ik de hele pipeline bouwen met self-hosted open-source OCR zodat niets je infrastructuur verlaat.
Kan je handgeschreven tekst of scans van lage kwaliteit verwerken?
Vaak wel, maar eerlijk gezegd varieert het meer dan bij gedrukte tekst. Handschrift, vervaagde scans, scheve foto's en lage resolutie faxen verminderen allemaal de nauwkeurigheid, en de mate hangt af van je documenten. Pre-processing helpt enorm. Stuur voorbeelden van je slechtste documenten in de Proof of Concept en ik help je verder.
Welke outputformaten krijg ik?
Wat het beste past bij jouw workflow: gestructureerde JSON, CSV, Excel of direct in je database of app via API. Vertel me waar de data naartoe moet en ik lever het in dat formaat, in plaats van dat je zelf een bestand moet converteren.
Ik heb alleen mijn PDFs één keer nodig omgezet te worden, geen heel systeem. Kun je dat doen?
Ja. Het Basic-pakket is precies dat: stuur tot 50 pagina's van één documenttype en ik lever een schone Excel-, CSV- of JSON-bestand terug. Als je dit later wilt automatiseren, zet het Standard-pakket dezelfde opzet om in een herbruikbare workflow.