Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
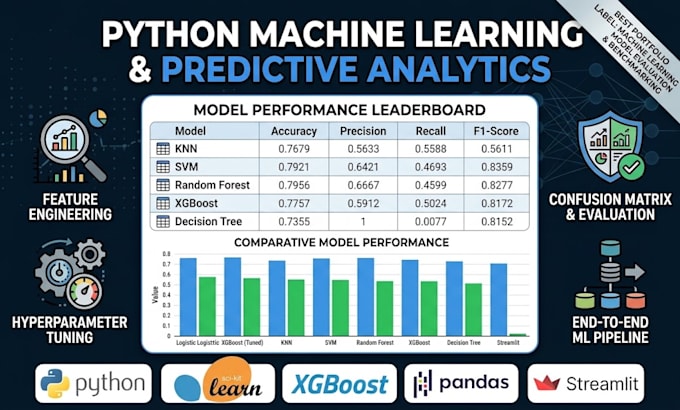
Heb je moeite om waardevolle voorspellingen en inzichten uit je complexe data te halen? Laten we je ruwe datasets omzetten in krachtige, decision-ready Machine Learning modellen die echte bedrijfsresultaten opleveren.
Ik richt me op het oplossen van jouw specifieke data-uitdagingen door nauwkeurige, robuuste en schone voorspellende pipelines te bouwen in Python.
Wat je krijgt met deze dienst:
Waarom met mij werken?


Programmeertaal:
Python
•
Colab
•
NoSQL
Frameworks:
Scikit-learn
•
keras
•
Panda
Tools:
Jupyter-notitieboek
•
tensorflow
•
Excel
•
Colab
Automatische vertaling
Welke Machine Learning taken voer je uit?
Ik bouw modellen voor classificatie, regressie, clustering, voorspellende analytics, feature engineering, hyperparameter tuning en klantverloop voorspelling met Python.
Welke Python bibliotheken en frameworks gebruik je?
Ik werk vooral met Scikit-Learn, XGBoost, LightGBM, Pandas, NumPy, Matplotlib, Seaborn en Streamlit voor web dashboards.
Ontvang ik de volledige Python broncode?
Ja, je ontvangt volledig gedocumenteerde Python code of Jupyter Notebooks met duidelijke stapsgewijze commentaar.
Kun je het ML-model als een interactieve webapp deployen?
Ja! Ik bouw en deploy een interactieve Streamlit dashboard zodat je voorspellingen live kunt testen met aangepaste inputs.
Welke datasetformaten accepteer je?
Ik werk met CSV, Excel, SQL databases en JSON-bestanden.
Hoe evalueer je de nauwkeurigheid van het model?
Ik evalueer modellen met gestandaardiseerde metrics zoals Accuracy, Precision, Recall, F1-score, ROC-AUC en Confusie-matrices om betrouwbare prestaties te garanderen.