Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Bouw slimme AI web apps en NLP-oplossingen voor data
Titel: Geautomatiseerde documentorganisatie & NLP-analyse
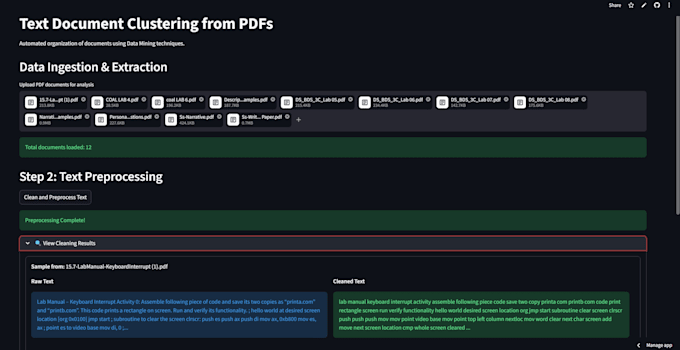
Hoi! Als je overweldigd bent door een enorme stapel PDF-documenten, kan ik je helpen ze te organiseren met AI-gestuurde NLP.
Ik groepeer niet alleen bestanden op basis van eenvoudige zoekwoorden. Ik gebruik geavanceerde semantische embeddings om de werkelijke betekenis van je tekst te begrijpen, zodat je documenten logisch en nauwkeurig worden gecategoriseerd.
Wat ik bied:
Ik focus op nauwkeurigheid en schone code. Stuur me vandaag nog een bericht om je project te bespreken!
Programmeertaal:
Python
Frameworks:
Scikit-learn
•
Panda
Tools:
Jupyter-notitieboek
•
Colab
Automatische vertaling
Wat voor soort PDF-documenten kun je verwerken?
Ik kan bijna elk tekstgebaseerd PDF verwerken, inclusief onderzoeksartikelen, zakelijke rapporten en artikelen.
Kun je ook Microsoft Word (.docx) bestanden verwerken?
Ja, absoluut! Hoewel de standaardversie van mijn tool geoptimaliseerd is voor PDFs, kan ik de data-inname pipeline eenvoudig aanpassen om .docx en .doc bestanden te verwerken.
Hoe zorg je dat de clusters nauwkeurig zijn?
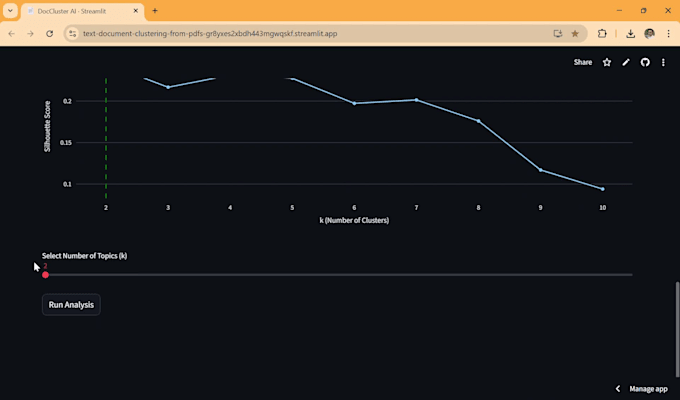
Ik gebruik een "Silhouette Score" analyse om mathematisch het meest logische aantal groepen voor jouw data te bepalen. Dit zorgt ervoor dat de clusters niet zomaar willekeurig zijn, maar gebaseerd op daadwerkelijke semantische dichtheid.
Moet ik de "Onderwerpen" vooraf aangeven?
Nee! Dit is "Unsupervised Learning," wat betekent dat de AI zelf de patronen en groepen in de documenten identificeert.
Zijn mijn gegevens veilig?
Absoluut. Ik verwerk je data lokaal op mijn beveiligde ontwikkelomgeving. Zodra het project is opgeleverd en geaccepteerd, verwijder ik je documenten uit mijn systeem, tenzij je anders aangeeft.
Kan ik het Streamlit-dashboard op mijn eigen computer draaien?
Ja. Als je kiest voor het Premium pakket, lever ik een requirements.txt bestand en een .devcontainer configuratie, zodat je de app gemakkelijk lokaal in VS Code kunt draaien of naar de cloud kunt deployen.