Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr


Automatische vertaling
Jouw documenten bevatten de antwoorden, maar ze vinden kost te veel tijd en een generieke chatbot zal er een verzinnen.
Ik bouw assistenten die uitsluitend uit jouw bestanden antwoorden en laat voor elk antwoord precies de pagina, regel of URL zien achter het antwoord. Als het bewijs niet in jouw documenten staat, zeggen ze dat in plaats van te gokken.
Twee niveaus, één systeem.
De Document Q&A-build (Basic en Standard) is een Python-app voor een kleine set bestanden: PDF, CSV, TXT, Markdown of webpagina’s. Het draait op jouw laptop, toont de bronnen onder elk antwoord en wordt geleverd met een installatiehandleiding.
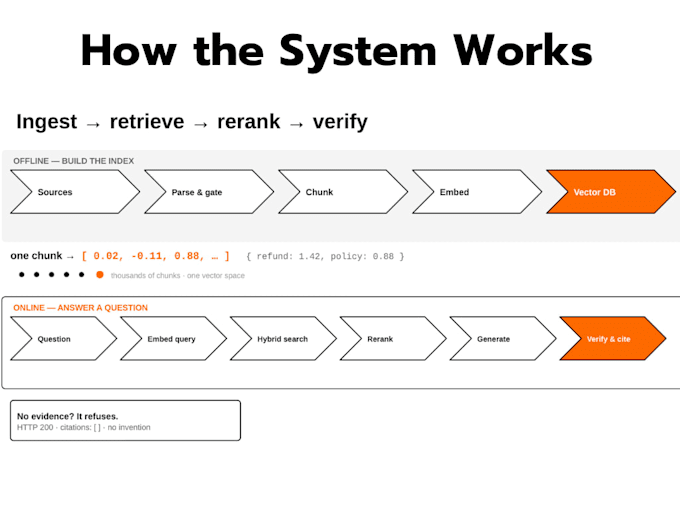
De ResearchOS-build (Premium) is voor grote corpora. Hybride zoekopdrachten die betekenis combineren met exacte termen, een LLM-herordening-stap, zinsbewuste chunking, een paginakwaliteitspoort die onleesbare pagina’s drop, en citaties gevalideerd voordat je ze ziet. Het wordt geleverd als FastAPI + PostgreSQL + Qdrant in Docker op jouw server, met een evaluatie-run op jouw eigen documenten.
Ik test alles tegen jouw voorbeeldvragen voor levering.
Niet inbegrepen: OCR voor gescande PDFs, multi-tenant SaaS, maatwerkmodeltraining, juridisch of medisch advies
AI Engineer, RAG, LLM Apps and Automation
Talen
Automatische vertaling
Automatische vertaling
Kan het gescande PDFs lezen?
Geen OCR. Pagina’s zonder tekstrand geven niets terug in plaats van gissen. In de Premium-build dropt de kwaliteitspoort ze expliciet en meldt hoeveel pagina’s overgeslagen zijn. Als jouw scan alleen beeld is, laat het me voor het bestellen weten; ik zeg je eerlijk of het werkt.
Wat is het verschil tussen Standaard en Premium?
Standard is een lichte lokale app voor een handvol bestanden. Premium is een deploybaar systeem voor een grote corpus: hybride zoekopdracht, herordening, een PostgreSQL + Qdrant-achtergrond, Docker en een meetbaar evaluatierapport. Als je twijfelt, stuur je pagina-aantal en ik wijs je naar de juiste tier.
Zondert het antwoorden te verzinnen?
Het is zo gebouwd dat het antwoorden weigert. Als retrieval geen bewijs vindt, geeft het een lege bronnenlijst terug in plaats van te genereren. In Premium worden citatie-nummers gevalideerd tegen wat daadwerkelijk is opgehaald, zodat verzonnen verwijzingen worden verwijderd voordat je het antwoord ziet.
Hoe nauwkeurig is het?
Ik meet het en rapporteer het. Op een testkorpus van 296 pagina’s: recall@10 1.00, nDCG@10 0.72, citatie-precisie 0.59, en elk antwoord is gebaseerd op ten minste één bron. Dat is een kleinschalige handgegrade baseline, geen benchmark — en iedereen die 100% citatie-nauwkeurigheid belooft, gissen.
Wordt mijn data ergens naartoe gestuurd?
Embeddings en antwoorden gaan naar OpenAI of Gemini met jouw sleutel. Jouw documenten, chunks en vectoren blijven op jouw eigen machine of server — PostgreSQL en Qdrant draaien lokaal in de Premium."
Heb ik een server nodig?
Basic en Standard: nee, jouw laptop. Premium: Docker met PostgreSQL en Qdrant; ik voeg het compose-bestand en deploy-notes toe.