Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
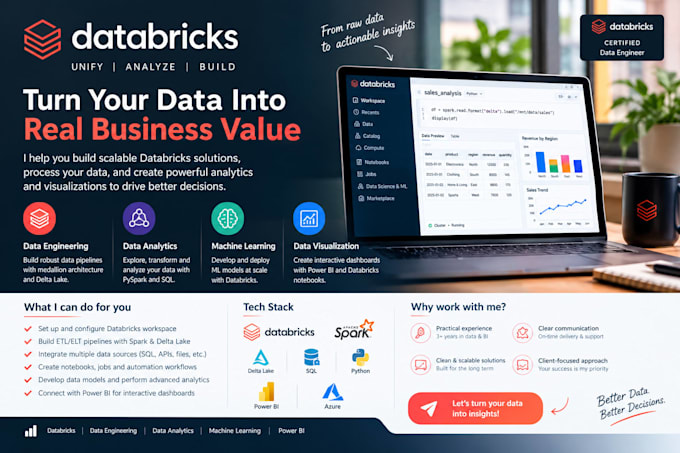
Transformeer je ruwe data in betrouwbare data pipelines met Databricks!
Zoek je hulp bij data processing, ETL pipelines of grote datatransformatie met Databricks?
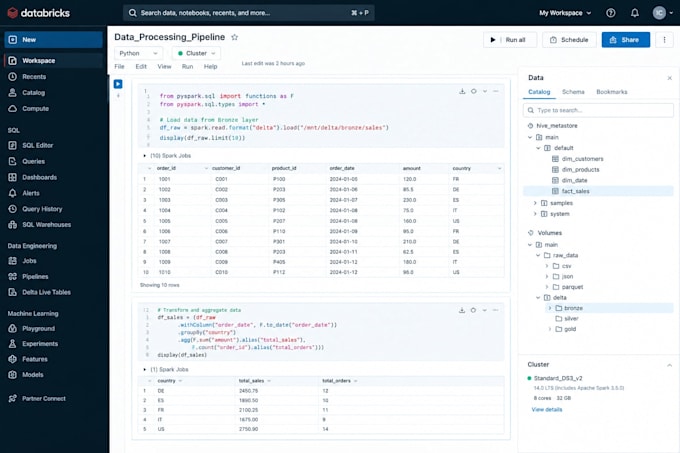
Ik kan je helpen bij het bouwen, optimaliseren en onderhouden van data pipelines met Databricks, PySpark, Python, SQL en Delta Lake, afgestemd op jouw projectvereisten.
Met meer dan 3 jaar ervaring in data-analyse, ETL-ontwikkeling, datatransformatie en business intelligence, weet ik hoe ik ruwe data kan omzetten in gestructureerde, betrouwbare en analyseklare datasets.
Mijn Databricks-diensten
1. Databricks & PySpark ontwikkeling
2. ETL/ELT data pipelines
3. Delta Lake & Lakehouse
4. SQL & Data optimalisatie
Automatische vertaling
Wat zijn je input data bronnen en formaten?
Heb je al een Databricks workspace?
Wat heb je nodig om te beginnen?
Graag ontvang ik je projectvereisten, voorbeeldgegevens, verwachte output en details over je Databricks omgeving.