Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD

Automatische vertaling
De meeste data problemen zijn geen analyseproblemen. Het zijn schoonmaakproblemen waar niemand naar wil kijken.
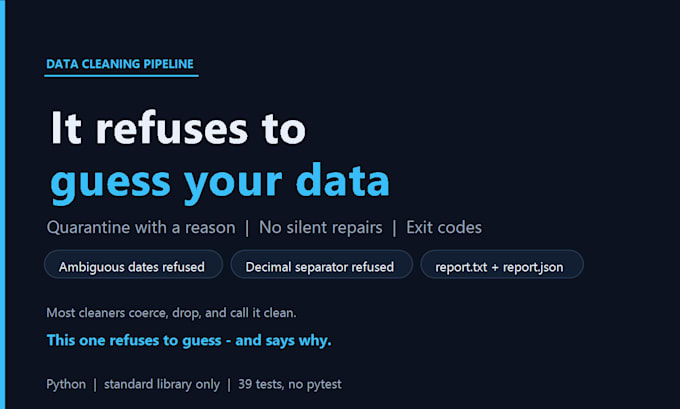
Een pipeline die stilletjes "foutieve" data corrigeert, is erger dan eentje die het weigert. Het verandert 15/01/2026 in de verkeerde maand, verwijdert 3% van de rijen, en produceert een rapport dat er schoon uitziet maar fout is.
WAT JE KRIJGT
- Een Python pipeline die je bestanden leest, wat ze kunnen bewijzen schoonmaakt, en de rest in quarantaine zet met een geschreven reden.
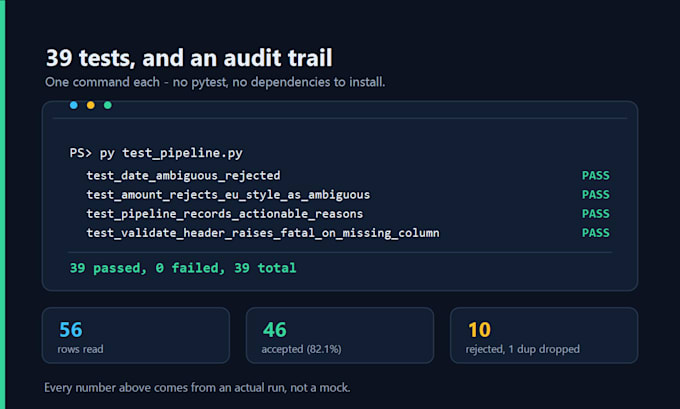
- Elke afgewezen rij gaat naar een eigen bestand met de bron en regelnummer. Niets wordt stilletjes verwijderd.
- Validatieregels die je kunt lezen en aanpassen: types, bereiken, verplichte velden, datumnotaties, duplicaten.
- Een controleerbaar rapport plus exit codes, zodat het luidruchtig faalt in plaats van een verkeerd bestand te schrijven.
- Tests, zodat je de regels kunt aanpassen zonder ze te breken.
- Een overdrachtsdocument: wat is gebouwd, hoe het te gebruiken, wat is geverifieerd, en de beperkingen.
HOE IK WERK
Ik bekijk je data voordat ik een offerte maak. Als een kolom ambigu is, vraag ik liever dan dat ik gok.
STACK
Python, alleen standaardbibliotheek. Niets te installeren.
Vertel me wat "schoon" betekent voor jouw data en ik zeg of het past. Voorbeelden op GitHub - stuur een bericht voor de link.
all
Talen
Automatische vertaling
Automatische vertaling
Welke bestandsformaten kun je verwerken?
Standaard CSV. Excel, TSV en vaste breedte tekst zijn ook prima. Je bronbestand wordt nooit aangepast - de pipeline leest het en schrijft nieuwe bestanden.
Wat gebeurt er met rijen die je niet kunt schoonmaken?
Ze gaan naar een apart afgewezen bestand met het bronrij-nummer en de reden. Niets wordt stilletjes verwijderd, en het rapport telt ze zodat je precies ziet wat is uitgesloten.
Verander je mijn originele data?
Nee. De pipeline leest alleen je input. Elke output is een nieuw bestand, dus je kunt altijd het resultaat vergelijken met de bron.
Kan het op een schema draaien?
Ja. Het stopt met een niet-nul code bij een fatale fout, zodat cron of Task Scheduler succes van falen kan onderscheiden zonder dat iemand de log hoeft te lezen.
Mijn kolommen betekenen iets specifieks voor mijn bedrijf.
Precies daarom vraag ik voordat ik een offerte maak. Stuur een voorbeeld en de validatieregels worden vastgelegd in je definities in plaats van te gokken op basis van de kolomnamen.