Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD

Automatische vertaling
Je documenten bevatten al de antwoorden. Ik ontwikkel de AI assistent die ze vindt.
Ik ontwerp op maat gemaakte Retrieval-Augmented Generation (RAG) apps waarmee je vragen in gewoon Engels kunt stellen en antwoorden krijgt die gebaseerd zijn op je eigen bestanden, met de exacte bronquote erachter.
In tegenstelling tot generieke chatbots die met vertrouwen feiten verzinnen, zijn mijn builds ontworpen tegen hallucinatie: elk antwoord wordt opgehaald uit je documenten, gecontroleerd volgens een strikte schema, en de ondersteunende quote wordt programmatisch gecontroleerd aan de hand van de brontekst. Onverifieerbare claims worden gemarkeerd, niet gefaked.
Wat ik bouw
Q&A chatbots over PDFs, rapporten, transcripties, contracten of een kennisbank
Gestructureerde extractie van gedefinieerde velden uit elk document
Cross-document synthese van gemeenschappelijke thema's en meningsverschillen
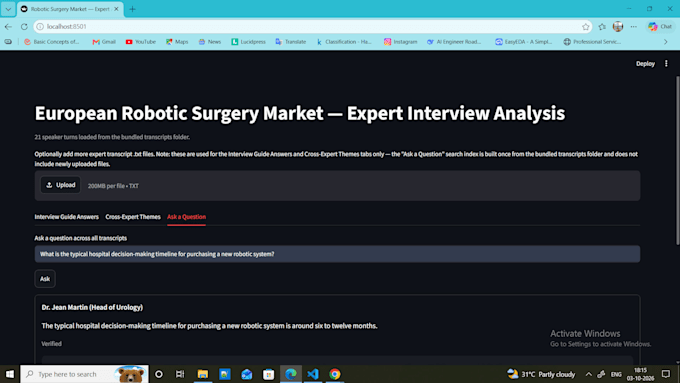
Een overzichtelijke Streamlit interface die je team daadwerkelijk kan gebruiken
Stack
LangChain, Hugging Face & OpenAI modellen, FAISS vector search, sentence-transformer embeddings, Pydantic gestructureerde outputs, Streamlit, Python.
Referentie build
Bekijk het portfolio-item een expert-interview analyser die geverifieerde quotes met timestamps uit markt-onderzoek transcripties teruggeeft.
Stuur me een bericht met je documenten en de vragen die je beantwoord wilt hebben
AI Engineer, LLMs, RAG, MultiAgents Systems, Python, LangGraph, LangChain
Talen
Automatische vertaling
Automatische vertaling
Met welke soorten documenten kun je werken?
PDF's, Word-bestanden, platte tekst, transcripties, CSV en gescrapte webpagina's. Als je een voorbeeld kunt delen, bevestig ik dat het netjes wordt geparset voordat je bestelt.
Hoe houd je de antwoorden accuraat?
Elk antwoord wordt alleen gegenereerd uit je documenten (retrieval-gebonden, niet uit het geheugen van het model), beperkt tot een strikte dataschema, en de ondersteunende quote wordt gecontroleerd aan de hand van de brontekst voordat het wordt getoond. Als het niet verifieerbaar is, wordt het gemarkeerd in de app in plaats van als feit gepresenteerd.
Welke AI-model gebruik je?
Het hangt af van je behoeften. Ik gebruik meestal Meta Llama 3.1 via Hugging Face, en kan OpenAI of een open lokaal model gebruiken als je lagere kosten of volledige privacy wilt. We kiezen samen in het eerste bericht.
Krijg ik de broncode?
Ja — elk pakket bevat de volledige, gedocumenteerde source code en een setup-gids. Geen lock-in.
Kan het privé draaien op mijn eigen data?
Ja. Voor gevoelige data kunnen we een self-hosted open model draaien zodat niets je omgeving verlaat.
Kun je het voor mij implementeren?
Ja, als een Premium feature of een gig extra. Je krijgt een werkende link en de hosting wordt geconfigureerd.
Hoeveel data kan het verwerken?
Het schaalt van een handvol bestanden tot duizenden documenten. Voor een grote corpus sla ik de vector index op schijf op zodat het niet bij elke run opnieuw wordt opgebouwd.
Wat heb je van mij nodig om te beginnen?
Je documenten (of een representatief voorbeeld), 3-5 voorbeeldvragen die je beantwoord wilt hebben, en eventuele branding- of interfacevoorkeuren.
