Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Gebruik de volledige ruimte van 1200 tekens om de Gig zoekwoordrijk te maken, maar blijf leesbaar:
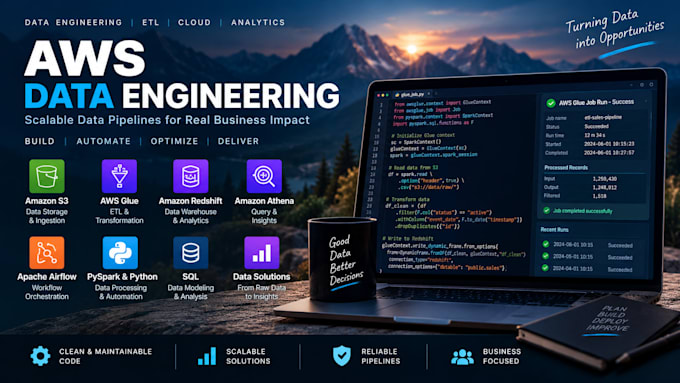
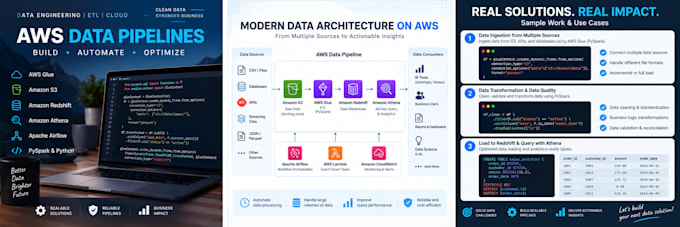
Ik bouw betrouwbare en schaalbare AWS ETL data pipelines met AWS Glue, PySpark, Python, Amazon S3, Amazon Redshift en andere AWS diensten.
Ik kan je helpen bij het ontwikkelen van nieuwe data pipelines, automatiseren van data verwerking, datasets transformeren of bestaande ETL workflows troubleshooten.
Mijn diensten omvatten:
AWS Glue ETL job ontwikkeling
PySpark en Python data transformaties
S3 data-inname en verwerking
CSV, JSON en Parquet data verwerking
Redshift data laden en transformeren
Athena en Apache Iceberg oplossingen
Data validatie en reconciliatie
Foutafhandeling en pipeline logging
ETL prestatie optimalisatie
Data migratie en automatisering
Ik richt me op schone, onderhoudbare en productieklare oplossingen met juiste validatie, foutafhandeling en documentatie.
Of je nu een kleine ETL taak hebt of een volledige AWS data pipeline, ik ontwikkel een oplossing op basis van jouw wensen.
Neem contact met mij op voordat je een bestelling plaatst voor complexe of multi-service vereisten, zodat ik je scope kan begrijpen en het juiste pakket kan aanbevelen.
Technologie:
Amazon Redshift
•
Excel
•
Python
•
SQL
•
NoSQL
•
Apache Airflow