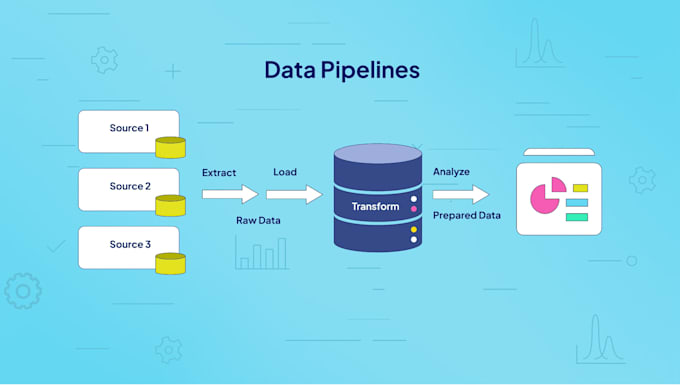
Ik ben een professionele Data Engineer met meer dan 3 jaar ervaring in het ontwerpen en optimaliseren van data platforms op grote schaal die dagelijks meer dan 400 TB verwerken. Of je nu end-to-end ETL-pijplijnen, real-time streaming of snelle analytische databases nodig hebt, ik bouw betrouwbare, kostenefficiënte datasystemen.
Wat ik voor jou kan doen:
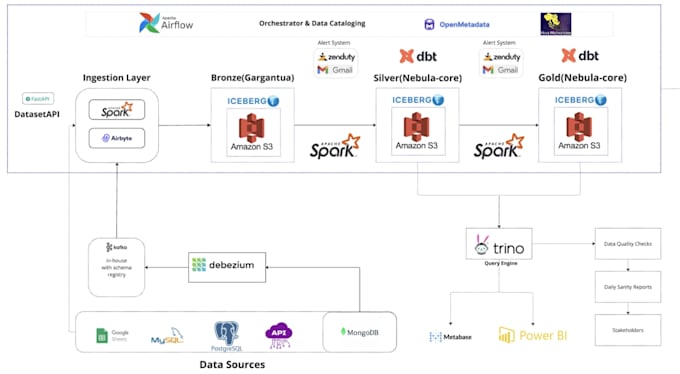
- ETL & ELT pijplijnen: Ontwerpen en automatiseren van schaalbare batchpijplijnen met Python, SQL, Apache Spark (PySpark) en Airflow.
- Moderne Lakehouse & Warehouse: Architectuur en setup met Apache Iceberg, Trino, ClickHouse, Redshift en PostgreSQL.
- Transformaties & modellering: Robuuste gold/silver lagen met dbt, modulaire data modellering en testen.
- Real-time CDC & streaming: Kafka-integratie, Debezium CDC en live ingestie in ClickHouse.
- Prestatieoptimalisatie: Complexe SQL-query's optimaliseren, knelpunten oplossen en infrastructuurkosten verlagen.
Waarom met mij werken?
- Productiegeteste engineering standaarden
- Schaalbare, schone en volledig gedocumenteerde code
- Duidelijke communicatie en op tijd leveren
Stuur me alsjeblieft een bericht voordat je een bestelling plaatst om je architectuur en wensen te bespreken!