Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
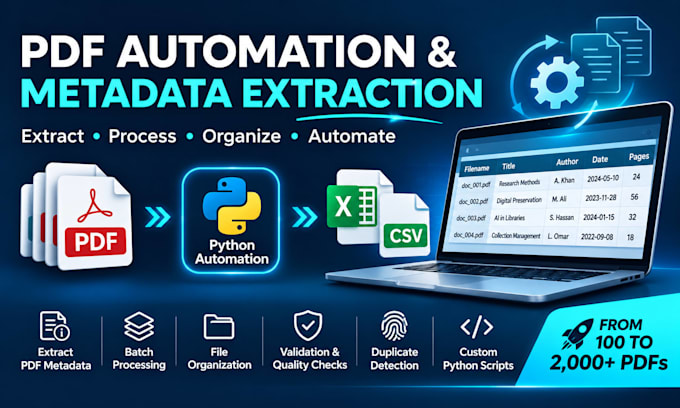
Nood aan efficiënte verwerking van honderden of duizenden PDF-bestanden?
Ik ontwikkel Python-automatiseringsoplossingen om bedrijven, onderzoekers en individuen te helpen metadata te extraheren, documenten te ordenen en repetitieve PDF-verwerkingstaken te automatiseren.
Mijn diensten omvatten:
Waarom kiezen voor mijn service?
Ik heb praktische ervaring met het ontwikkelen van grootschalige documentverwerkings- en metadata-workflows. Ik richt me op betrouwbare, geteste oplossingen met duidelijke documentatie.
Wat je ontvangt:
Afhankelijk van jouw pakket ontvang je gestructureerde metadata-rapporten, herbruikbare Python-scripts of een aangepaste PDF-verwerkingsworkflow.
Neem voor bestelling contact op om jouw wensen te bespreken.
Let op: OCR, tekstherkenning van gescande documenten en complexe lay-outs vereisen een offerte op maat.
Technologie:
Python
Expertise:
Data-extractie
•
Gegevensmanipulatie
Automatische vertaling
Kun je honderden of duizenden PDF-bestanden verwerken?
Ja! Ik kan Python-automatiseringsworkflows ontwikkelen om grote verzamelingen PDF's te verwerken. Mijn pakketten coveren respectievelijk tot 100, 500 of 2.000 bestanden; voor grotere verzamelingen geldt een offerte op maat.
Welke informatie kun je uit PDF-bestanden halen?
Ik kan beschikbare metadata extraheren zoals documenttitels, auteurs, aanmaak- en wijzigingsdatums, paginaantallen, bestandsgrootte en PDF-versies. Extractie hangt af van de informatie die in elk document is ingebed.
Kun je tekst uit gescande PDFs halen?
Ja, OCR-gebaseerde extractie kan besproken worden als een maatwerkdienst. Standaardpakketten richten zich op ingebedde PDF-metadata en omvatten geen OCR of handschriftherkenning.
In welke formaten ontvang ik de geëxtraheerde gegevens?
CSV is inbegrepen bij alle pakketten. Excel (.xlsx) of JSON-uitvoer kan ook geleverd worden als dit vooraf afgesproken is. Herbruikbare Python-scripts zijn inbegrepen bij de Standard en Premium pakketten.
Heb je toegang nodig tot mijn computer of server?
Geen externe toegang is meestal nodig. Ik kan de oplossing ontwikkelen en testen met representatieve voorbeeldbestanden. Je kunt vervolgens het geleverde script op jouw Windows- of Linux-computer draaien.
Hoe ga je om met vertrouwelijke documenten?
Ik raad aan geanonimiseerde of niet-gevoelige voorbeeldbestanden te delen wanneer mogelijk. Ik gebruik projectbestanden alleen voor het afgesproken werk en deel ze niet met derden. Bespreek bij bestelling eventuele speciale vertrouwelijkheids- of gegevensbehandelingsvereisten.
Kun je een maatwerk PDF-verwerkingsworkflow maken?
Ja! Ik kan workflows ontwikkelen voor metadata-extractie, batch-naamgeving, duplicaatdetectie, bestandsvalidatie en gestructureerde rapportage. Neem contact op met jouw wensen zodat ik de scope kan inschatten en een passende offerte kan geven.
