Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Senior Data Engineer die zich specialiseert in Cloud ETL en Architectuur
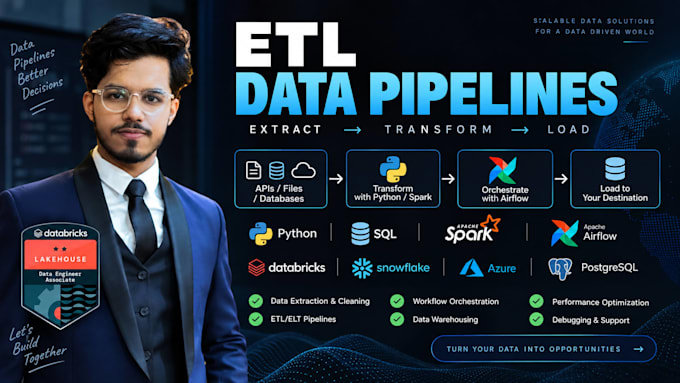
Heb je een betrouwbare ETL-pipeline nodig om je data workflow te automatiseren?
Ik bouw een schone, schaalbare ETL/ELT-pipeline met Python, SQL, Apache Spark/PySpark en Airflow.
Ik kan je helpen met:
Je krijgt schone, onderhoudbare code, goede documentatie en een oplossing die op jouw wensen is afgestemd.
Heb je een bestaande pipeline die niet werkt? Ik kan het probleem opsporen en optimaliseren.
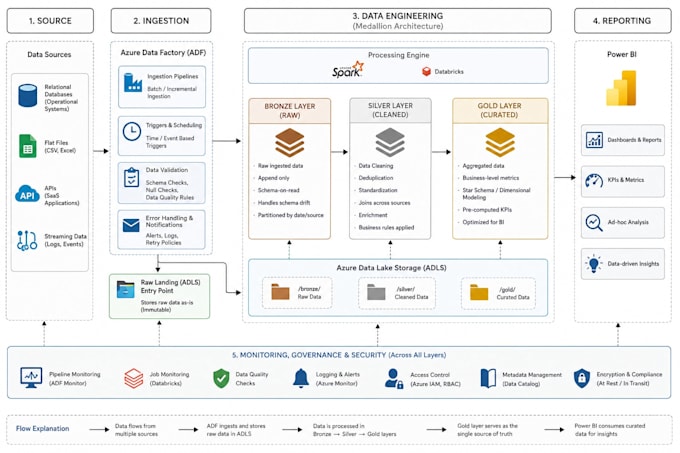
Tools & platforms:
Azure Data Factory
Automatische vertaling
Met welke soorten databronnen kan ik werken?
Ik kan werken met SQL-databases, CSV/Excel-bestanden, REST APIs, cloud storage, JSON-data en vele andere gestructureerde databronnen.
Kun je Apache Airflow-workflows bouwen?
Ja. Ik maak Airflow DAGs met planning, afhankelijkheden, retries, logging en monitoring.
Ondersteun je Apache Spark?
Ja. Ik bouw Spark-pijplijnen voor grootschalige data processing, transformaties en ETL-workloads.
Kun je terugkerende data jobs automatiseren?
Absoluut. Ik maak geplande pijplijnen die automatisch data extraheren, transformeren, valideren en laden.
Kun je de pijplijn deployen?
Ja. Deployment hulp met Docker of cloud platforms kan als Gig Extra of in het Premium pakket worden inbegrepen.