Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Enterprise data engineer die geautomatiseerde pipelines bouwt en SQL optimaliseert
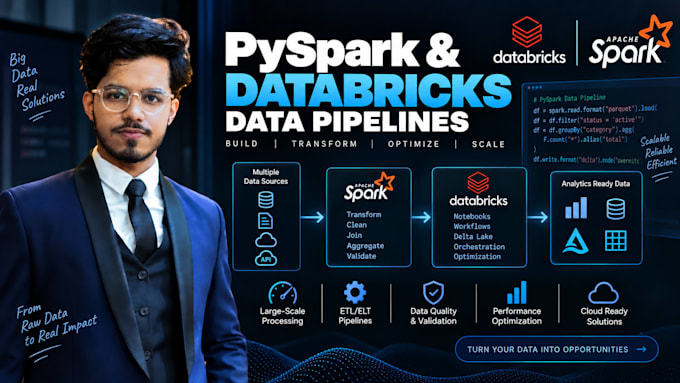
Hulp nodig bij het verwerken van grote datasets met PySpark of Databricks?
Ik bouw schaalbare data pipelines met PySpark, Apache Spark en Databricks voor data transformatie, verwerking en analyse.
Ik kan helpen met:
Ik richt me op schone, onderhoudbare en efficiënte pipelines met duidelijke documentatie.
Neem contact met me op voordat je bestelt voor complexe projecten, zodat ik je data en wensen beter kan begrijpen.
Warehouse Platform:
Snowflake
•
Azure Synapse
•
Databricks
Projecttype:
Nieuwbouw
Automatische vertaling
Werk je met Databricks?
Ja. Ik kan PySpark notebooks, transformaties, ETL workflows en data-verwerkingspipelines in Databricks bouwen.
Kun je grote datasets verwerken?
Ja. PySpark is ontworpen voor gedistribueerde verwerking, en ik kan pipelines bouwen voor grote datasets.
Kun je een bestaande Spark pipeline optimaliseren?
Ja. Ik kan trage jobs onderzoeken en transformaties, joins, partitions en Spark workloads optimaliseren.
Kun je incrementele pipelines bouwen?
Ja. Ik kan incrementele/batch verwerking implementeren op basis van jouw wensen en beschikbare data.
Welke datastromen kan ik gebruiken?
Ik kan werken met bestanden, APIs, databases, cloud storage en data warehouses, afhankelijk van het project.
Kun je werken met Snowflake of andere warehouses?
Ja. Ik kan pipelines bouwen die data transformeren en laden in platforms zoals Snowflake en andere ondersteunde warehouses.
Heeft u documentatie?
Ja. Documentatie is inbegrepen volgens het gekozen pakket.
Moet ik contact met u opnemen voordat ik bestel?
Ja, vooral voor complexe projecten. Deel je data bronnen, verwachte transformaties, bestemming en geschatte datavolume.
