Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Senior Data Engineer die zich specialiseert in Cloud ETL en Architectuur
Nog steeds afhankelijk van trage SQL Server-verversingen?
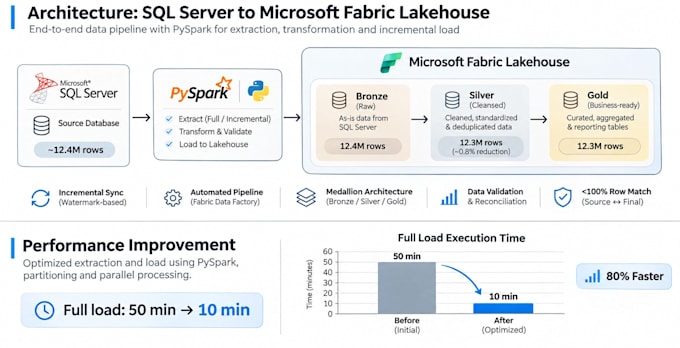
Ik migreer jouw SQL Server-tabellen naar Microsoft Fabric Delta Lake, en bouw daarmee geoptimaliseerde full-load-pijplijnen en incremental pipelines op basis van watermark.
Wat ik lever:
Mijn hands-on ervaring: Fabric-pijplijnen gebouwd met staged upserts en incrementele loading, waardoor de uitvoeringstijd van ongeveer 50 naar ongeveer 10 minuten werd verkort door optimalisatie.
Ideaal voor teams die legacy SQL Server- en SSIS-workflows moderniseren.
Deel je schema en ruw aantal rijen om aan de slag te gaan. Stuur me een bericht voordat je bestelt voor grote migraties.
Warehouse Platform:
Azure Synapse
•
Fabric Warehouse
•
Databricks
Projecttype:
Migratie
Automatische vertaling
Werk je met onpremise SQL Server of Azure SQL?
Beide. Voor onpremise deel je een schema-export en een voorbeeldrijen. Voor Azure SQL kan ik direct koppelen. Vermeld je versie (SQL Server 2016, 2019, 2022 of Azure SQL) bij het berichten.
Heb ik al een Microsoft Fabric-werkruimte nodig?
Nee. Het Premium-pakket bevat Lakehouse- en workspace-installatie vanaf scratch. Voor Basic en Standard is een Fabric-trial of betaalde workspace nodig. Ik kan je begeleiden bij de setup als extra service.
Wat is een watermark-gebaseerde incrementele pijplijn?
Na de initiële volledige laadpoging gebruikt de pijplijn een timestamp- of auto‑increment-kolom om alleen nieuwe of gewijzigde rijen uit SQL Server te extraheren en upserten naar Fabric Delta-tabellen, geen volledige reload nodig. Jouw data blijft continu up-to-date.
Kun je opgeslagen procedures en views migreren?
Tabelgegevens en PySpark-pijplijnlogica zijn inbegrepen. Conversie van stored procedures naar Fabric-notebooks of T-SQL-tegenhangers kan als aangepaste opdracht worden toegevoegd; stuur eerst details mee.
Hoe ga je om met tabellen van 100M+ rijen
Ik ontwerp met partitionering, batch-extractie en incrementele logica vanaf het begin. Voor zeer grote tabellen bevat het migratieplan in het Basic-pakket de aanbevolen partitioneringssleutel en batchstrategie voordat er code geschreven wordt.
Krijg ik de code en kan ik het zelf onderhouden?
Ja. Alle PySpark-notebooks, pijplijnlogica en documentatie zijn van jou. Standaard en Premium bevatten inline codecomments en een stapsgewijze README, zodat jouw team de pijplijnen zelfstandig kan uitbreiden of onderhouden.