Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Systemen en ML-projecten C Python SQL Op tijd en geoptimaliseerd
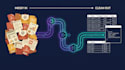
Data vastgezet in PDFs, e-mails of documenten die je niet kunt gebruiken? Ik bouw AI-gestuurde Python-pipelines die je ongestructureerde data extraheren, opschonen en structureren en die leveren waar je ze nodig hebt.
WAT IK BOUW
PDF-, e-mail- en documentextractie
Web scraping + gestructureerde output
LLM-classificatie, tagging & samenvatting
Data opschonen & deduplicatie
Multi-bron samenvoegen & API-integratie
Geautomatiseerde planning (dagelijks, wekelijks, op trigger)
Output naar PostgreSQL, BigQuery, Excel, Sheets, S3, Airtable
WAAROM AI IN JE PIPELINE?
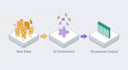
Traditionele ETL faalt bij ongestructureerde data. AI-verrijking betekent:
Veldextractie uit vrije tekst zonder breekbare regex
Automatische classificatie en labeling van records op schaal
Inconsistenties automatisch verwerken
Anomalieën markeren voordat ze je database bereiken
Schone Python-code die jij mag behouden
Gedocumenteerde, onderhoudbare pipeline
Geteste output met voorbeeldgegevens
Ondersteuning na levering
Stuur me eerst een bericht met je data bron, wat je wilt laten extraheren en waar de output naartoe moet.

Automatische vertaling
Welke invoerformaten ondersteun je?
PDF's, Word-documenten, Excel/CSV-bestanden, platte tekst, e-mails (EML/MSG), websites, REST API's, databases (PostgreSQL, MySQL, MongoDB) en cloudopslag (S3, Google Drive). Als je formaat niet vermeld staat, stuur me een bericht, ik heb nog nooit een formaat gevonden waarmee ik niet kan werken.
Wat betekent "AI-verrijking" eigenlijk binnen een pipeline?
Het betekent het gebruik van een taalmodel als transformatiestap — niet als chatbot, maar als extractiemachine. In plaats van fragiele regels te schrijven om een vendornaam uit een rommelige factuur te halen, leest het model de tekst en geeft het een schoon gestructureerd veld terug.
Wordt de code van mij?
Ja, volledige source code is inbegrepen bij elke opdracht. Het is schone, gedocumenteerde Python-code zonder verborgen afhankelijkheden, zodat jij, jij of je team het kunnen lezen, aanpassen en zelfstandig uitvoeren na levering.
Kan de pipeline automatisch op een schema draaien?
Ja — Standaard- en Premium-pakketten bevatten geautomatiseerde planning. Ik kan het zo instellen dat het dagelijks, wekelijks of op een trigger draait (bijvoorbeeld wanneer een nieuw bestand in een map komt of een webhook afgaat). Basic is standaard een eenmalige run, maar planning kan als extra worden toegevoegd.
Wat als mijn datavolume heel groot is?
Stuur me eerst een bericht met de geschatte volume. Voor grote datasets bouw ik pipelines met batching, retry-logica en kostenbewuste API-gebruik, zodat je AI-verrijking kosten voorspelbaar blijven en je geen verrassingsrekeningen krijgt.
Heb ik mijn eigen AI API-sleutel nodig?
Het hangt ervan af. Voor lichte taken kan ik open-weight modellen gebruiken zonder API-sleutel. Voor GPT-4 of Claude-klasse verrijking heb je je eigen sleutel nodig. Ik vertel je precies welke en wat het ongeveer kost voor jouw volume voordat je bestelt.


