Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Python backend en automation expert, FastAPI, web scraping, REST APIs
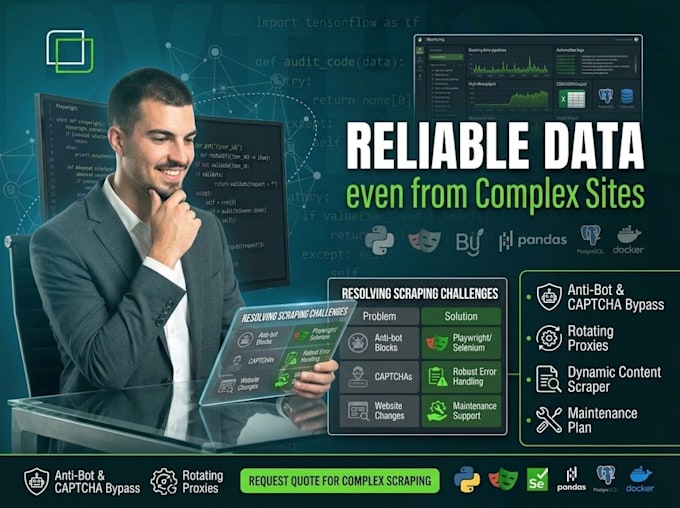
Ik bouw productieklare web scrapers die data betrouwbaar extraheren, zelfs van complexe JavaScript-sites.
Wat mij onderscheidt:
Wat je krijgt:
Perfect voor:
Tech stack:
Python Playwright BeautifulSoup Pandas APScheduler PostgreSQL Docker


Technologie:
Python
•
Selenium
•
Beautiful Soup
•
Toneelschrijver
•
Pandas
Techniek:
Geautomatiseerd
Automatische vertaling
Welke soorten websites kun je schrapen?
Ik kan de meeste websites scrapen, inclusief JavaScript-rijke sites (met Playwright), e-commerce platforms, listing sites en data aggregators. Ik handel paginering, oneindige scroll en dynamische content af. Sites met anti-bot bescherming vereisen aangepaste oplossingen — neem eerst contact op om de haalbaarheid te beoordelen.
Wat telt als "één bron" of "één pagina"?
Eén bron = één domein/website. Eén pagina = één unieke URL die wordt gescraped (productpagina, listing, artikel). Paginering via resultaatspagina's telt als meerdere pagina's. Ik bevestig de exacte scope voordat ik begin om verwarring te voorkomen.
In welk dataformaat ontvang ik de data?
Jij kiest: CSV, JSON, Excel (XLSX), of directe database levering (PostgreSQL/SQLite). Data wordt correct geformatteerd, gevalideerd, met verwijderde duplicaten en ontbrekende waarden. Schoon, klaar voor gebruik output.
Geef je de broncode door?
Ja, alle pakketten bevatten het volledige Python script met duidelijke documentatie. Je kunt het zelf uitvoeren of ik help je met het plannen op je server. Premium pakket bevat assistentie bij deployment.
Kun je websites scrapen met login/authenticatie?
Ja, ik regel login flows, cookies en sessiebeheer. Authenticatie scraping is inbegrepen in de Standard en Premium pakketten.
Is webscraping legaal?
Het scrapen van publiek beschikbare data is over het algemeen legaal, maar ik respecteer altijd robots.txt en rate limits. Ik scrape geen auteursrechtelijk beschermd materiaal, persoonlijke data of betaalmuren omzeilen. Jij bent verantwoordelijk voor hoe je de data gebruikt.
Wat als de website verandert na levering?
Alle scrapers bevatten foutmeldingen. Als de site structuur binnen 30 dagen na levering verandert, update ik de scraper één keer gratis. Daarna zijn updates beschikbaar als betaalde revisies.
Wat als de website scrapers blokkeert of CAPTCHAs heeft?
Ik gebruik roterende proxies, user-agent rotatie en kan CAPTCHA-oplossingsdiensten integreren indien nodig (Premium pakket). De meeste sites kunnen ethisch gescraped worden zonder blokkades te veroorzaken.
Breekt mijn scraper als de website verandert?
Ik bouw scrapers met robuuste selectors en foutafhandeling. Kleine wijzigingen aan de site breken het meestal niet. Grote redesigns kunnen updates vereisen (inbegrepen in het Premium onderhoudsplan).
Kun je data rechtstreeks naar mijn database leveren?
Ja! Ik kan leveren aan PostgreSQL, MySQL, MongoDB of elke andere database die je gebruikt (Standard en Premium pakketten).