Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Ben je op zoek naar een ervaren Databricks-data engineer om een betrouwbare, schaalbare datapijplijn te bouwen? Ik ben een Databricks Geaccrediteerd Data Engineer met meer dan 5 jaar ervaring in het bouwen van grootschalige ETL-pijplijnen met PySpark, Spark SQL en Delta Lake voor wereldwijde klanten in financiën en gezondheidszorg.
Wat ik lever:
Waarom samenwerken met mij:
Als je meer dan 3 bronnen of maatwerk wensen hebt, stuur ik een aangepaste aanbieding.
Automatische vertaling
Welke cloud platformen ondersteun je?
Ik ben gespecialiseerd in Azure Databricks, inclusief ADLS Gen2-opslag en Azure Data Factory.
Wat als ik meer dan 3 gegevensbronnen heb?
Stuur me voor bestelling je wensen en ik doe je een aangepaste aanbieding.
Wat krijg ik uiteindelijk?
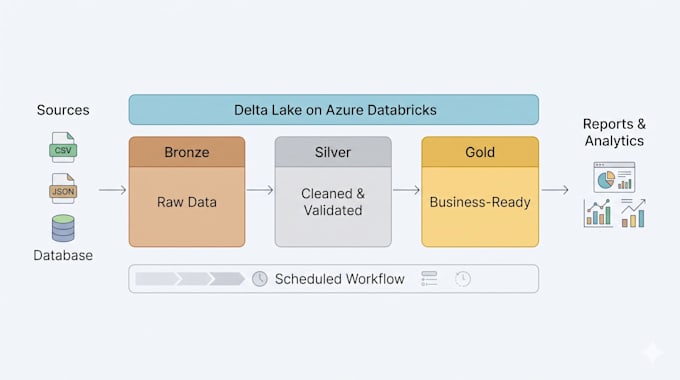
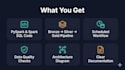
PySpark/Spark SQL-notebooks, een geplande Databricks-workflow, een architectuurdiagram en documentatie die laat zien hoe je de pijplijn draait en onderhoudt.
Kun je werken met mijn bestaande datavorm?
Ja. Ik kan CSV, JSON, Parquet, Delta en databanktabellen inlezen. Deel een voorbeeld voordat je bestelt als jouw formaat ongebruikelijk is.