Door categorieën bladeren
Nederlands
$
USD
Maak verbinding met je AI
Wil je schone, betrouwbare data van websites, geen rommelige eenmalige dump? Ik bouw Python-scrapers die omgaan met realistische sites en leveren gededuplicateerde, direct te gebruiken data op.
Als backend-engineer heb ik scraping- en aggregatiepipelines gebouwd die 10+ bronnen samenvoegden tot ~1M records met 95% deduplicatienauwkeurigheid.
Wat je krijgt:
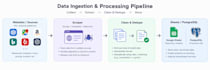
- Statische en JavaScript-rijke sites (Scrapy, Selenium, Puppeteer)
- Paginering, retries en beleefde snelheidslimieten ingebouwd
- Schoonmaken, dedupliceren en consistente formatting
- Output naar CSV, Excel, JSON, Google Sheets of PostgreSQL
- Optionele AI-stap om rommelige velden te categoriseren of standaardiseren
- Broncode die jij bezit (Standaard en hoger) en geplande runs (Premium)
Geschikt: product- en prijsgegevens, bedrijvengidsen, vastgoed- en vacaturelijsten, openbare datasets, concurrentie-monitoring.
Ik verzamel alleen openbaar beschikbare, niet-persoonlijke data en respecteer de grenzen van elke site. Stuur me de website en velden die je nodig hebt, dan bevestig ik de haalbaarheid voordat je bestelt.

Technologie:
Python
Techniek:
Geautomatiseerd
Automatische vertaling
Kun je elke website schrapen?
De meeste openbare websites, ja, ook JavaScript-rijke. Ik verzamel geen persoonsgegevens, geen scraping van profielen op sociale media en geen omzeiling van inlog- en betaalmuren. Stuur me de link en velden en ik bevestig voordat je bestelt.
Blijft de scraper werken als de website verandert?
Sites veranderen, dus bouw ik scrapers met duidelijke selectors, logging en foutmeldingen zodat fixes snel gaan. Kleine aanpassingen binnen 7 dagen na levering zijn gratis; grotere herontwerpen kunnen apart worden geoffreerd.
Voer je de scraper voor mij uit of krijg ik de code?
Basic levert alleen de data. Standard en Premium omvatten de volledige Python-broncode, en Premium omvat installatie op jouw server of cloudaccount zodat het op schema draait.
