Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Heb jij rigoureuze, reproduceerbare bioinformatica-analyse voor jouw onderzoek nodig?
Ik bied aangepaste R/Python-analyse aan met openbare databases of jouw eigen datasets.
Ik kan helpen met:
Pakketten:
Basis: Een duidelijk gedefinieerde taak.
Standaard: Kern single-omics-analyse.
Premium: Afgebakende end-to-end bioinformatica-workflow.
Standaard en Premium bevatten reproduceerbare code, benodigde figuren zonder vaste figuurgrens en gedetailleerde rapporten (methoden, resultaten, interpretatie en beperkingen).
Stuur me even een bericht voordat je bestelt om data, doelen, scope en tijdlijn te bevestigen. Geen garantie op bevindingen of publicatie.
Automatische vertaling
Welke bioinformatica analyses bied je aan?
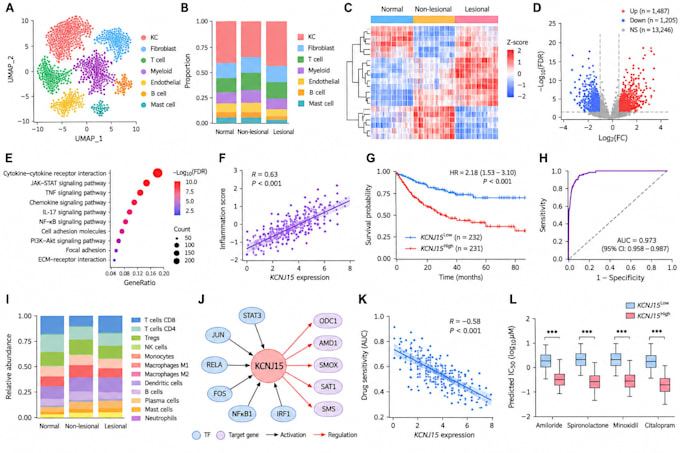
Ik bied TCGA/GEO-datamining, differentiële expressie, GO/KEGG, GSEA, WGCNA, overlevingsanalyse, machine learning, immuuninfiltratie, single-cell en spatial transcriptomics, multi-omics-integratie, voorspellende druggevoeligheid en meer. Aangepaste analyses zijn welkom.
Met welke databases kun je werken?
Ik werk met TCGA, GEO, GTEx, ICGC, CPTAC, GDSC, TARGET, CGGA, TCPA, ArrayExpress, METABRIC, exoRBase en andere openbare biomedische databases. Ik kan meerdere datasets integreren wanneer dat wetenschappelijk verantwoord is.
Kun je een volledig bioinformatica-onderzoeksproject aanpakken?
Ja! Ik kan een aangepaste bioinformatica-workflow ontwerpen en uitvoeren, inclusief data-analyse, statistische analyses, machine learning, biologische interpretatie en validatie met onafhankelijke datasets wanneer beschikbaar. De scope en prijs worden voor bestelling bevestigd.
Krijg ik het volledige code, wetenschappelijke figuren en gedetailleerde rapporten?
Zeker! Standaard- en Premium-pakketten bevatten reproduceerbare R/Python-code, alle benodigde wetenschappelijke figuren binnen de afgesproken analysis-scope en gedetailleerde rapporten over methoden, statistische resultaten, biologische interpretatie en beperkingen. Er is geen vaste figuurlimiet.
Kun je prognostische modellen of machine learning-modellen bouwen en valideren?
Ja. Ik bied Cox-regressie, LASSO, random forest, SVM, kenmerkenselectie, overlevingsanalyse, ROC-evaluatie en modellering-interpretatie. Interne validatie en onafhankelijke externe validatie kunnen worden meegenomen wanneer geschikte data beschikbaar zijn.
Ondersteunt u single-cell, spatial transcriptomics en multi-omics analyse?
Ja! Diensten omvatten single-cell QC, clustering, annotatie, differentiële expressie, trajectanalyse, celcommunicatie, spatial visualisatie en multi-omics-integratie. Grote of rekenintensieve projecten kunnen een aangepaste offerte vereisen.
Kun je medicijnvoorspelling, moleculaire docking en moleculaire dynamica-simulaties uitvoeren?
Ja. Ik bied computationele drug-sensitiviteitsanalyse, kandidaatmedicijnprioritering, moleculaire docking en moleculaire dynamica-simulaties wanneer gepast. Deze analyses genereren onderzoeks-hypothesen en leveren geen klinische efficiëntie op.
Wat moet ik aanleveren voor bestelling en hoe worden complexe projecten geprijsd?
Deel alsjeblieft jouw onderzoeksdoelen, datatype, datasetgrootte en verwachte deliverables. Basis dekt één kleine taak, Standaard dekt een scoped single-omics-analyse en Premium dekt een gedefinieerde end-to-end-workflow. Complexe projecten kunnen een aangepaste offerte krijgen.