Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
AI Engineer, LLM Chatbot en Python Django Expert
Python Web Scraping | Data Extractie | Web Automatisering
Heb je betrouwbare data extractie nodig zonder ontbrekende velden, kapotte scripts of IP-blokkades? Ik bouw high-performance Python web scrapers en automatiseringsworkflows die gestructureerde data ophalen van zelfs complexe statische en dynamische websites, inclusief anti-bot maatregelen, proxies en snelheidslimieten.
Wat ik Kan Scrapen & Extracten:
Leveringen:
Technische Stack: Python, Selenium, Scrapy, BeautifulSoup, Playwright, Pandas
Stuur me een bericht met de URL van je doelwebsite en de data velden die je nodig hebt. Ik bevestig de haalbaarheid en geef je binnen enkele uren een nauwkeurige offerte.
Opmerking: De haalbaarheid hangt af van de structuur van de site en de anti-scraping maatregelen die aanwezig zijn.

Technologie:
Python
•
Scrapy
•
Selenium
•
Beautiful Soup
•
Pandas
Techniek:
Geautomatiseerd
Automatische vertaling
Werkt dit op elke website?
De meeste websites, ja — inclusief JavaScript-zware en dynamische sites. Sommige sites met zware anti-bot bescherming (strikte CAPTCHAs, inlogwanden) kunnen extra tijd vereisen of zijn niet altijd mogelijk. Stuur me eerst de URL en ik bevestig het.
Hoe ga je om met IP-blokkades of blokkades?
Ik gebruik proxies, request throttling en header/user-agent rotatie om detectie te voorkomen en het scrapen stabiel te houden, vooral voor grote of herhaalde opdrachten.
Kun je data achter een login krabben?
Ja, als je geldige inloggegevens of toegang verstrekt, kan ik inlogflows automatiseren en data achter inlog beschermen.
In welk formaat ontvang ik de gegevens?
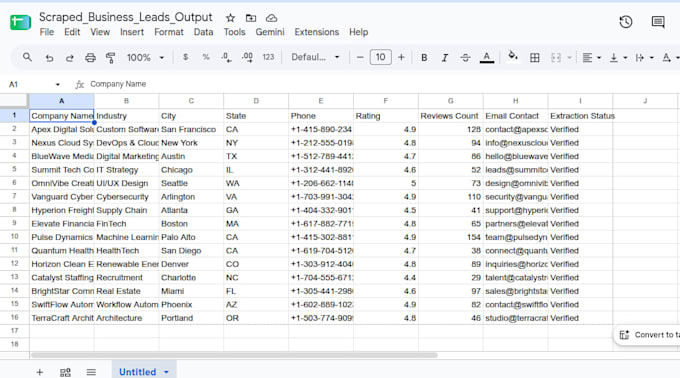
Excel (.xlsx), CSV, JSON of direct gesynchroniseerd met Google Sheets — wat voor jou het beste werkt.
Krijg ik de broncode van de scraper?
Ja, beschikbaar als extra. Ik lever schone, commentaar gevulde Python code zodat je het later zelf kunt draaien of aanpassen.
Hoe ga je om met grootschalig scrapen (10.000+ records)?
Ik gebruik asynchrone requests, batching en proxy rotatie om op grote schaal te scrapen zonder te crashen of geblokkeerd te worden, met ingebouwde foutafhandeling en retries.
Is webscraping legaal?
Ik scrape alleen publiek beschikbare data en volg de gebruiksvoorwaarden van elke site waar van toepassing. Ik doorbreek geen betaalmuren of haal geen privé/persoonlijke data zonder toestemming.