Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Data-analist, Power BI, SQL, Python, Excel
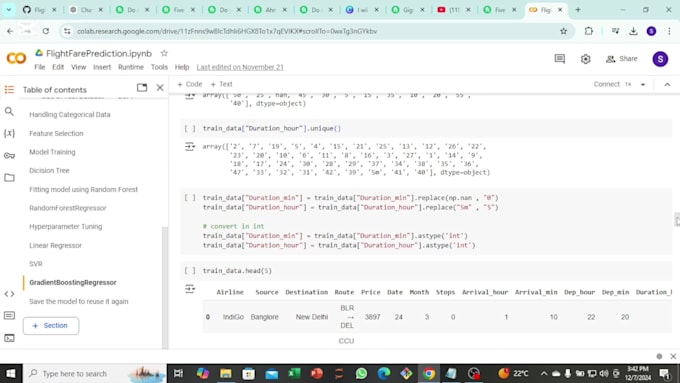
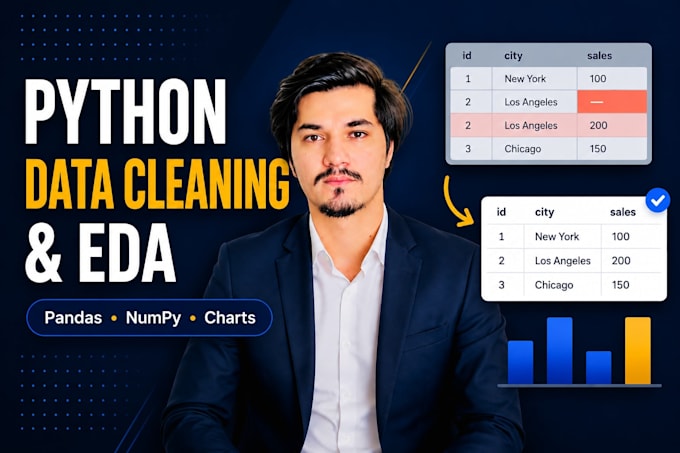
Ik ruim rommelige datasets op in Python (Pandas en NumPy) en verken ze vervolgens om verdelingen, trends, relaties en ongewone patronen te laten zien.
Wat ik doe:
Je ontvangt een schoongemaakt CSV- of Excel-bestand, een Jupyter Notebook (.ipynb) met elke stap en jouw grafieken als PNG-bestanden. Hogere pakketten bevatten een geschreven samenvatting, een PDF-rapport, een change log en een herbruikbaar opschoningsscript.
Optionele extra: basis machine learning (simple regressie of classificatie met Scikit-learn). Staat niet in de pakketten en kost extra, dus stuur eerst een berichtje. Ik bekijk jouw data voordat ik een aangepaste offerte stuur.
Niet inbegrepen: deep learning, deployment, dashboards en web scraping.
Ik ben nieuw op Fiverr, dus ik leg uit wat ik heb aangepast en waarom. Stuur me vóór de bestelling een klein voorbeeld van jouw bestand.
_ounhds.jpg)
Technologie:
Jupyter-notitieboek
Expertise:
Zakelijke inzichten
•
Trends
•
Statistieken
Programmeertaal:
Python
Tools:
Google Colab
•
Overige
Automatische vertaling
Met welke bestandsformaten werk je?
CSV, Excel (.xlsx) en JSON. Voor elk ander formaat, stuur me vooraf een bericht en ik laat je weten of ik het kan openen.
Hoe ga je om met ontbrekende waarden en duplicaten?
Ik kijk ze eerst na en vertel je wat ik vind. Daarna pas ik de door jou gekozen regel toe: invullen, verwijderen of markeren. Als je geen voorkeur hebt, gebruik ik een standaardbenadering en leg ik die uit in het notebook.
Wat is exploratieve data-analyse (EDA)?
Een eerste blik op jouw data: samenvattende statistieken, verdelingen, groeperingen, correlaties en vreemde waarden. Het laat zien wat er in de data zit en wat aandacht nodig heeft.
Welke grafieken krijg ik?
Statische grafieken gemaakt met Matplotlib en Seaborn, zoals histogrammen, staafdiagrammen, boxplots, spreidingsdiagrammen en heatmaps. Ze worden geleverd als PNG-bestanden en zijn geen interactieve dashboards.
Wat ontvang ik en krijg ik de Python-code?
Een schoongemaakt datasetbestand, een Jupyter Notebook met elke stap en jouw grafieken. Standaard bevat een geschreven samenvatting. Premium bevat een PDF-rapport, een change log en een herbruikbaar .py-schoonmaakscript.
Bied je machine learning aan?
Ja, basis regressie of classificatie met Scikit-learn, als aparte betaalde dienst. Staat niet in de pakketten. Stuur eerst een berichtje zodat ik jouw data kan bekijken en een aangepaste offerte kan sturen. Ik kan geen specifieke nauwkeurigheid beloven.
Hoe groot kan mijn dataset zijn?
Basis: 1 bestand, 10.000 rijen, 15 kolommen. Standaard: 2 bestanden, 50.000 rijen, 30 kolommen. Premium: 3 bestanden, 100.000 rijen, 50 kolommen. Voor grotere data kun je me een offerte op maat vragen.
Bied jij deep learning, dashboards of deployment aan?
Nee. Deze dienst dekt Python-schoonmaak, analyse en statische grafieken, plus basis ML als maatwerk. Ik bied Power BI- en Excel-dashboards aan in aparte diensten.