Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Automatische vertaling
Maak routinematige document- en mapwerkzaamheden makkelijker om te herhalen.
Ik bouw een lokale Python-workflow om bestaande tekst uit digitale PDFs te extraheer, een directory te inventariseren, identieke inhoud te identificeren, of een georganiseerde kopie van mappen te maken volgens afgesproken regels.
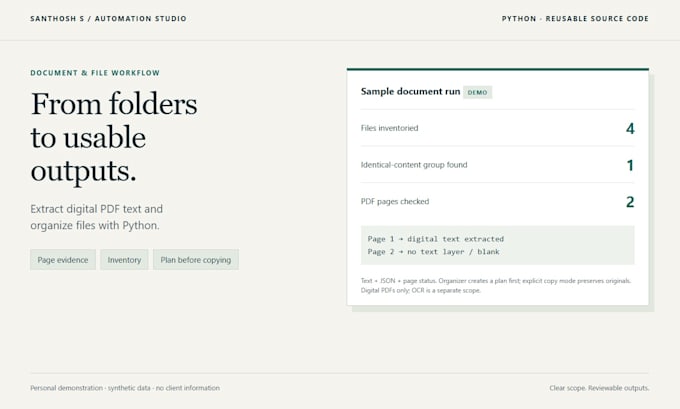
Output kan bestaan uit een TXT per document, pagina-niveau JSON, een status-CSV en een inventaris met relatieve paden, groottes en SHA-256-fingerprints. Lege pagina's of pagina's zonder uit te kunnen lezen content worden gemarkeerd.
De organisator maakt eerst een controleerbaar plan. Explicieve copy-modus behoudt de originelen en verifieert de resultaten. Het verplaatst of verwijdert je bronmateriaal niet.
Je ontvangt herbruikbare code, run-instructies, voorbeeldoutput en een samenvatting. Mijn persoonlijke demo gebruikt synthetische data: vier items geïnventariseerd en een twee pagina's tellend voorbeeld gecontroleerd, inclusief één lege pagina.
Scans, OCR, handschrift, tabellereconstructie, beveiligde documenten en web scraping vereisen aparte afbakening. De leesvolgorde hangt af van de oorspronkelijke structuur.
Premium omvat één Windows-installatie-stappenplan en 14 dagen aan geleverd-scope defectoplossingen.
Stuur een geschoonde voorbeeldset, tellingen, totale grootte en jouw gewenste output voordat je kiest voor een pakket.
Senior Executive
Talen
Automatische vertaling
Automatische vertaling
Kun je gescande PDFs of afbeeldingen verwerken?
Deze package behandelt digitale PDFs met een bestaande tekstlaag. Scans en handschrift vereisen een apart scope OCR-workflow. Pagina's zonder tekst worden gemarkeerd in plaats van geraden.
Wordt de tabellen en de oorspronkelijke PDF-indeling bewaard?
Nee. De uitgang bevat tekst met pagina-aanduiding. De leesvolgorde van PDFs kan variëren en reconstructie van tabellen of behoud van lay-out vereist een apart op basis van voorbeelden gebaseerde scope.
Gaat de organizer mijn bestanden verplaatsen of verwijderen?
Nee. De standaarduitvoering maakt een plan. Een expliciete kopieeruitvoering maakt georganiseerde kopieën en verifieert inhoudshashes; originelen blijven bewaard. Dubbele inhoud wordt alleen gemeld.
Kan ik de automatisering opnieuw uitvoeren?
Ja. Brontoof en een run-gids zijn inbegrepen. Ingangen moeten de afgesproken structuur behouden en elke run schrijft naar een nieuw of leeg output-mapje.
Welke organisatieregels zijn inbegrepen?
Premium dekt groeperen op bestandsextensie of gewijzigde UTC-maand terwijl de oorspronkelijke relatieve mapstructuur behouden blijft. Bedrijfsspecifieke classificatie of PDF-veld-extractie vallen buiten de scope.
Welke bestanden moet ik delen?
Stuur eerst een geschoond representatief voorbeeld en tellingen. Lever ontsperde PDF-kopieën aan. Stuur geen wachtwoorden of onnodige persoonlijke data mee. We bevestigen de scope voordat we met de volledige batch aan de slag gaan.
Wat zijn de bestand-, pagina- en groottebeperkingen?
Basis: 20 PDFs/100 pagina's/50 MB. Standaard: 100 PDFs/500 pagina's/200 MB plus 1.000 inventarisbestanden. Premium: 200 PDFs/1.000 pagina's/300 MB plus 5.000 inventarisbestanden en tot 2 GB aan kopieën. Zowel PDF-telling als gecombineerde paginalimiet geldt.
