Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD


Automatische vertaling
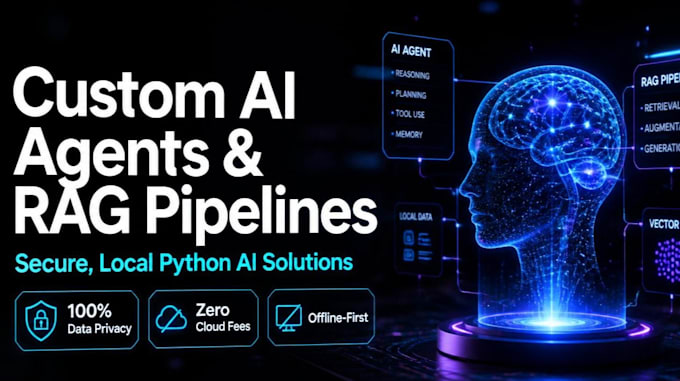
Ben je op zoek naar een veilige, lokale AI-agent of RAG-pipeline zonder dure cloud API-kosten? Als IBM & Microsoft gecertificeerde AI-engineer, specialiseer ik me in het bouwen van offline-first Python AI-systemen die zijn afgestemd op jouw bedrijfsgegevens.
Ik ontwerp productieklare lokale LLM-werkomgevingen die eigendomsdocumenten omzetten in doorzoekbare intelligentie, zodat jouw data 100% privé blijft.
Wat ik voor je kan bouwen:
Jouw data blijft volledig onder jouw controle. Laten we een krachtig AI-gereedschap bouwen dat geoptimaliseerd is voor jouw workflow.
Stuur me een bericht om te beginnen!
AI Engineer, Python Automation, Computer Vision
Talen
Automatische vertaling
Automatische vertaling
Wat is een lokale RAG-pipeline en waarom heb ik die nodig?
Een RAG-pipeline stelt een aangepaste AI-agent in staat om jouw specifieke bedrijfsdocumenten (zoals PDFs of Markdown) te lezen en te begrijpen. Door een lokale LLM te gebruiken, betaal je geen maandelijkse cloud API-kosten, en blijft je gevoelige data 100% privé en veilig op je eigen machine.
Welke modellen en tools gebruik je voor de AI-agent?
Ik ben gespecialiseerd in Python AI-ontwikkeling. Ik bouw vector-databases met ChromaDB en orchestreren krachtige lokale modellen zoals DeepSeek-R1, Qwen en Llama via Ollama. Voor de frontend maak ik strakke interactieve dashboards met Streamlit AI.
Kun je ervoor zorgen dat de AI niet hallucineert of feiten verzint?
Ja! Ik ontwerp enterprise-grade AI-agenten met zelfcorrectie-lussen en schema-validatie. Omdat de RAG-pipeline het model dwingt je geüploade documenten te citeren, zijn de antwoorden onderbouwd, zeer nauwkeurig en betrouwbaar voor zakelijk gebruik.
Heb ik een dure computer nodig om een lokale LLM te draaien?
Het draaien van een lokale LLM via Ollama vereist wel wat basis RAM- en GPU-bronnen. Ik optimaliseer de modellen voor jouw specifieke hardware. Indien nodig, kunnen we ook een hybride setup bouwen die ervoor zorgt dat je systeem soepel draait zonder lag.