Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
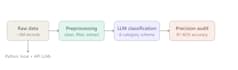
Heb je ongestructureerde tekstdata die moet worden omgezet in schone, gelabelde categorieën? Ik ontwerp en bouw classificatiepipelines met behulp van grote taalmodellen (lokaal of via API) en Python, getest op schaal in een project dat ongeveer 3 miljoen tekstrecords verwerkt.
Wat ik aanbied:
- Aangepaste tekstclassificatieschema's op maat van jouw categorieën
- LLM-gebaseerde labeling (lokale modellen zoals Llama, of API's zoals DeepInfra/OpenAI)
- Python data cleaning en preprocessing pipelines
- Nauwkeurigheidscontrole zodat je weet hoe betrouwbaar de resultaten zijn
- Duidelijke documentatie van methodologie en resultaten
Waarom met mij werken:
Master-onderzoeker (Taipei Medical University, 4.0 GPA) met praktische ervaring in het bouwen en valideren van grootschalige classificatiesystemen. Ik geef om nauwkeurigheid, niet alleen snelheid. Elke pipeline die ik bouw bevat een validatiestap zodat je op de resultaten kunt vertrouwen.
Stuur me je data en categorieën, en ik bepaal de juiste aanpak voor jouw project.