Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Lead Python-ontwikkelaar Data-automatisering en extractie
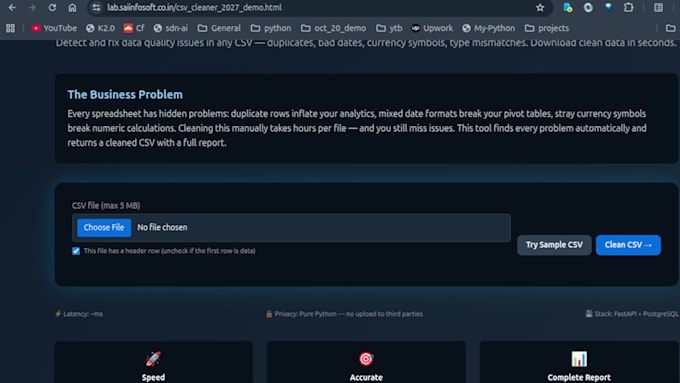
Verspil geen uren meer aan handmatig opruimen van rommelige spreadsheets!
Hoi, ik ben Shailendra. Ik bouw praktische, razendsnelle Python-tools die rommelige bedrijfsdata omzetten in schone, gestructureerde en bruikbare resultaten.
PROBLEEM:
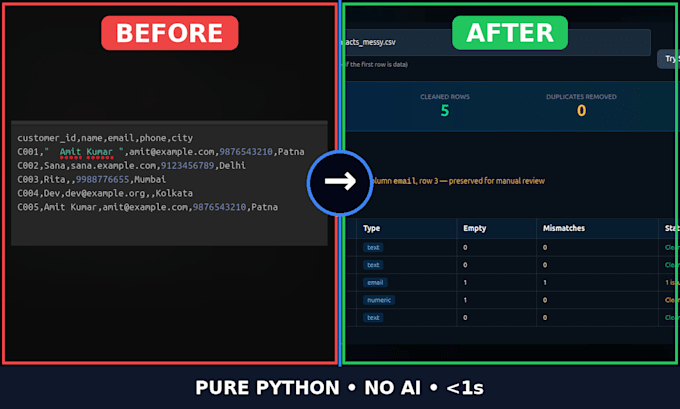
Bedrijven verliezen tijd en maken dure fouten door dubbele records, inconsistent datumnotaties, ontbrekende waarden en ongestructureerde datasets in CSV- of Excel-bestanden.
OPLOSSING:
Ik schrijf een op maat gemaakt Python-script met regels om jouw data cleaning-pipeline te automatiseren.
100% voorspelbare resultaten (geen AI-black boxes)
Geen dataverlies of overschrijving van oorspronkelijke bestanden
Subseconde verwerking, zelfs bij gigantische datasets
Omgaat met complexe opmaak, vage duplicaten en type-matches
DELIVERABLE:
Een perfect schone, gestandaardiseerde uitvoerfile (CSV, Excel of JSON)
Volledige, goed gedocumenteerde Python-broncode
Een gedetailleerd "Issue Summary Report" waarin precies staat wat is gecorrigeerd, samengevoegd of geweigerd
Korte documentatie zodat jouw team het altijd kan draaien
️ BELANGRIJK: STUUR ME VOOR DE BESTELLING een voorbeeld van jouw rommelige data. Ik deel ook een link naar mijn live interactieve demo zodat je het eerst kunt testen! Zo zorgen we voor een vlotte, 5-sterren levering.
Automatische vertaling
Gebruik je AI om de data schoon te maken?
Nee. Ik werk met puur Python (zoals Pandas en eigen logica). Dit zorgt voor 100% voorspelbare resultaten, geen hallucinaties en volledige privacy van de data.
Zal je mijn oorspronkelijke data verwijderen of overschrijven?
Absoluut niet. Het script maakt een geheel nieuw, schone uitvoerfile en een "Rejected Rows"-rapport. Je originele bestand raakt nooit aangeraakt of gewijzigd.
Kun je bestanden met miljoenen rijen aan?
Ja. De Standard- en Premium-tier zijn speciaal geoptimaliseerd met chunking en geheugenbeheer om enorme datasets effectief te verwerken zonder te crashen.