Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Onderzoeksenthousiast
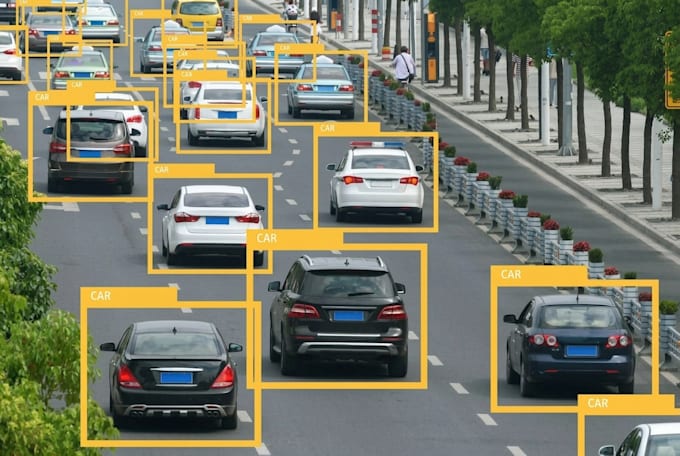
Stop met verlies van modelnauwkeurigheid door slechte labels. Krijg hier high-precision AI data!
Worstelt je met lage nauwkeurigheid in voorspellingen? Je model is slechts zo krachtig als de data die het voedt! Ik bied topklasse data annotatie en bounding box labeling, zodat je sneller dan ooit high-performing AI-modellen kunt trainen.
Waarom samenwerken met mij?
Even een heads-up: deze dienst is exclusief voor Bounding Box Annotation. Wil je polygons, segmentation of aangepaste workflows? Stuur me een bericht voordat je bestelt en we maken een op maat gemaakt plan!


Techniek:
Handleiding
Type tagging:
Tekst
•
Afbeelding
•
Video
Automatische vertaling
Welke bestandsformaten accepteer en lever je?
Ik werk met standaard beeldformaten (JPEG, PNG, TIFF) en exporteer annotaties in elk formaat dat jouw pipeline vereist, inclusief JSON, XML, CSV, YOLO (.txt), Pascal VOC of COCO.
Hoe waarborg je de kwaliteit en nauwkeurigheid van de annotaties?
Elk dataset ondergaat een twee-staps kwaliteitscontrole: handmatige labeling volgens jouw specifieke richtlijnen voor edge-cases, gevolgd door een grondige review om 100% boundary precisie, correcte class labeling en geen gemiste objecten te garanderen.
Deze dienst is voor Bounding Boxes—wat als ik Polygon of Segmentation labeling nodig heb?
Hoewel deze aanbieding standaard voor Bounding Box annotatie is, ondersteun ik volledig Polygon Annotatie, Keypoint/Landmark labeling en Semantic Segmentation. Stuur me gerust een bericht met jouw wensen, zodat ik een op maat gemaakte aanbieding kan maken.
Kan ik mijn eigen labeling richtlijnen en schema volgen?
Ja. Voorafgaand aan de start bekijk ik jouw projectdocumentatie, edge-case regels en class definities om volledige afstemming met jouw bestaande computer vision pipeline te garanderen.
Hoe ga je om met dataset privacy en databeveiliging?
Jouw dataprivacy is gegarandeerd. Ik deel, publiceer of gebruik jouw datasets nooit voor andere doeleinden dan jouw project, en ik ben bereid een Non-Disclosure Agreement (NDA) te ondertekenen indien nodig.
Kan ik een kleine testbatch bestellen voordat ik me vastleg aan een grote dataset?
Absoluut. Ik moedig aan om een kleine steekproef (bijvoorbeeld 10-20 beelden) te doen om de labelnauwkeurigheid te verifiëren en te bevestigen dat het exportformaat geschikt is voor jouw training pipeline voordat je opschaalt.