Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD


Automatische vertaling
Ben je op zoek naar een betrouwbare Machine Learning expert om modellen te bouwen, trainen en evalueren voor jouw data?
Ik ben gespecialiseerd in het ontwikkelen van Machine Learning oplossingen, waaronder:
Of het nu een universiteitsproject, onderzoeksrapport of zakelijke dataset is, ik lever schone, goed gedocumenteerde en nauwkeurige resultaten met Python (Scikit-learn, Pandas, NumPy, Matplotlib, Seaborn).
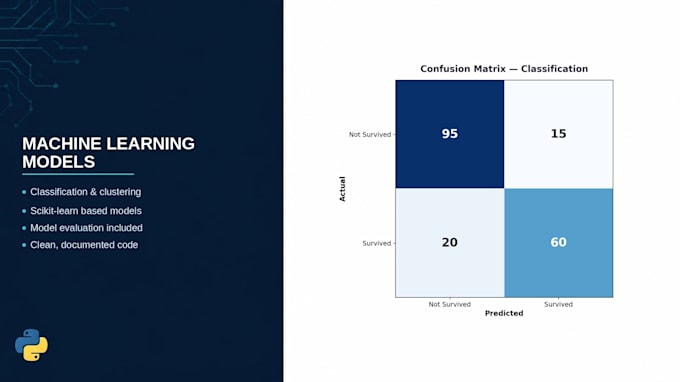
Bekijk mijn portfolio hieronder voor voorbeeldgrafieken van nauwkeurigheidsvergelijkingen, verwarringsmatrices en resultaten van eerdere projecten.
Waarom voor mij kiezen?
Laten we jouw data omzetten in waardevolle inzichten!
Turning Raw Data Into Clear, Actionable Visuals with Python
Talen
Automatische vertaling
Automatische vertaling
Welke tools/talen gebruik je?
Ik gebruik vooral Python met libraries zoals Scikit-learn, Pandas, NumPy, Matplotlib en Seaborn.
Kun je werken met mijn eigen dataset?
Ja, deel gewoon je dataset (CSV/Excel) en ik bouw het model op basis daarvan.
Krijg ik de broncode?
Ja, je ontvangt volledige, goed commentaar gegeven broncode (Jupyter Notebook of .py bestand) samen met de resultaten.
Leg je de resultaten uit?
Ja, ik leg de nauwkeurigheid, verwarringsmatrix en modelvergelijking duidelijk uit — ideaal voor studenten en presentaties.
Kun je meerdere algoritmes vergelijken en de beste aanbevelen?
Absoluut — het vergelijken van nauwkeurigheid, precisie, recall en F1-score tussen modellen om de beste te vinden, is een van mijn kernservices.
Heb je voorbeeldwerk dat ik kan zien voordat ik bestel?
Ja, bekijk mijn portfolio-afbeeldingen / voorbeelden op deze gig-pagina voor voorbeelden van eerdere projecten en resultaten.