Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Ben je op zoek naar een expert Machine Learning Engineer om op maat gemaakte ML-modellen te bouwen, LLMs te verfijnen of productie AI-pijplijnen te implementeren? Je bent op de juiste plek!
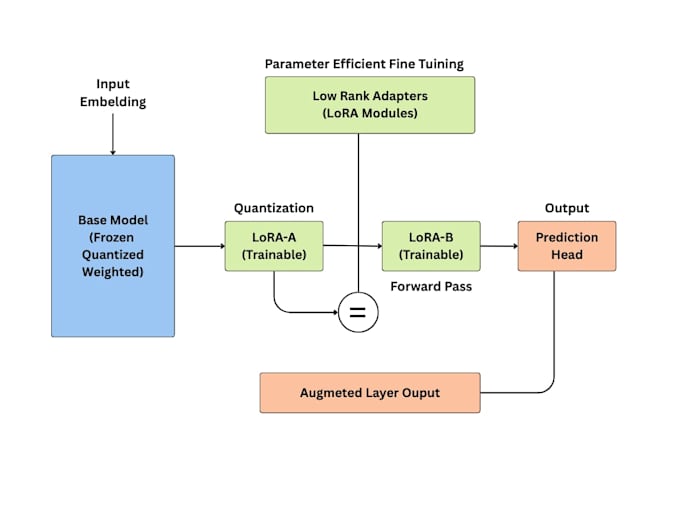
Ik ben gespecialiseerd in het ontwikkelen van end-to-end Machine Learning en Generative AI oplossingen die zijn afgestemd op jouw specifieke zakelijke of onderzoeksbehoeften. Van data cleaning tot parameter-efficiënt verfijnen (QLoRA/LoRA) en API-implementatie, ik lever schone, productieklare code.
Wat ik aanbied:
Waarom voor mij kiezen?



Programmeertaal:
Python
•
SQL
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
•
Overige
Tools:
Jupyter-notitieboek
•
opencv
•
Excel
•
CVAT
•
Colab
Automatische vertaling
Welke informatie of bestanden moet ik aanleveren voordat ik een bestelling plaats?
Geef een duidelijke beschrijving van je projectdoelen, je dataset (indien beschikbaar) en eventuele specifieke prestatie-eisen of rekenbeperkingen (bijvoorbeeld GPU-geheugen, cloudomgeving). Als je nog geen dataset hebt, kan ik adviseren over dataverzameling of preprocessing.
Kun je Large Language Models (LLMs) verfijnen op maat gemaakte datasets?
Ja! Ik ben gespecialiseerd in parameter-efficiënt verfijnen (PEFT) met QLoRA en LoRA technieken op modellen zoals Llama 3, Mistral en Hugging Face architecturen. Ik optimaliseer modellen zodat ze efficiënt draaien op low-resource GPU's (bijvoorbeeld een enkele T4 GPU) terwijl ze hoge nauwkeurigheid behouden.
Welke machine learning en deep learning frameworks gebruik je?
Ik werk voornamelijk met Python, PyTorch, TensorFlow, Scikit-Learn, Hugging Face Transformers, OpenCV en FAISS voor vector search. Voor web API-implementatie gebruik ik Flask en FastAPI.
Ontvang ik de volledige broncode en modelbestanden?
Ja! Elk pakket bevat schone, volledig gedocumenteerde Python broncode (Jupyter Notebooks of modulaire scripts) samen met getrainde modelgewichten en stapsgewijze setup-instructies.
Kan je het ML-model integreren in een werkende webapplicatie of API?
Absoluut. In het Premium pakket (of via Gig Extras) kan ik een Flask of FastAPI backend bouwen, interactieve dashboards maken met Streamlit, of Docker containers opzetten voor naadloze deployment.
Wat als mijn dataset rommelig, ongestructureerd of incompleet is?
Geen probleem! Data preprocessing, missing value handling, feature engineering en data cleaning maken allemaal deel uit van mijn ML workflow in alle pakketten.
Hoe zorgen we voor modelkwaliteit en prestaties?
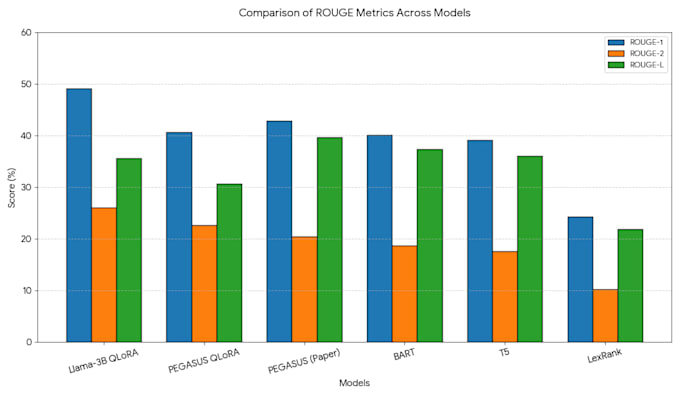
Ik evalueer modellen met standaard metrics (Accuracy, Precision, Recall, F1-Score, ROUGE scores voor NLP, of R² voor regressie) en houd experimenten bij om reproduceerbare, optimale resultaten te garanderen.